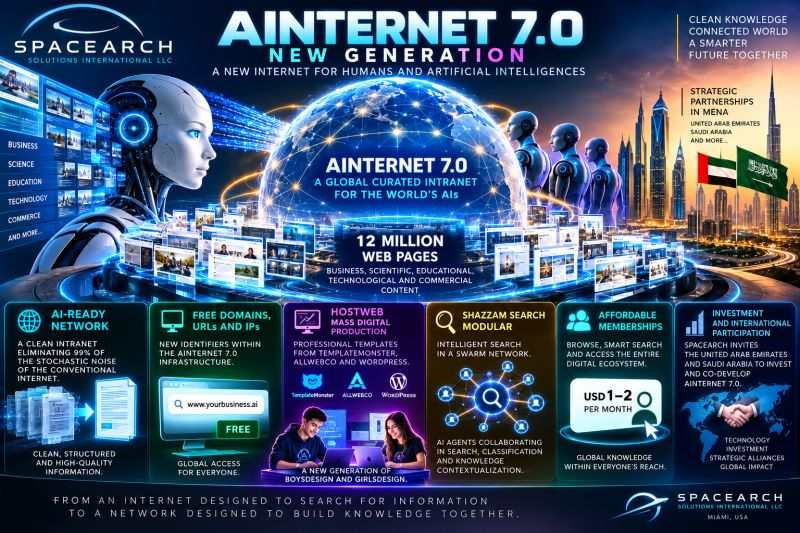
AINTERNET 7.0 — AI-NATIVE INTERNET ARCHITECTURE™
De una Internet construida para publicar y buscar información a una infraestructura diseñada para humanos, empresas y agentes de inteligencia artificial
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation
Componentes iniciales: HostWeb · Shazzam Search Modular · AI Agents · Semantic Knowledge Infrastructure
Clasificación: Internet de Nueva Generación / IA / Infraestructura Digital / Búsqueda Inteligente / Conocimiento Distribuido
Estado: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL Y DISEÑO PRELIMINAR
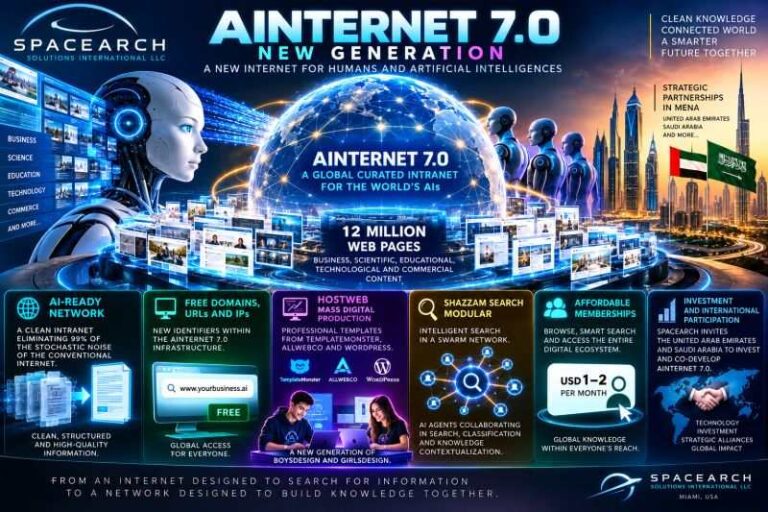
Objetivo prospectivo: hasta 12 millones de páginas organizadas dentro de una infraestructura digital curada
Modelo económico propuesto: membresía aproximada de USD 1–2 mensuales, sujeta a validación
Año: 2026
DECLARACIÓN DE ESTADO DEL PROYECTO
AInternet 7.0 se encuentra en fase de proyecto.
SpaceArch está desarrollando el concepto y la arquitectura preliminar de una infraestructura digital orientada a investigar una transición desde la Web predominantemente diseñada para navegación, publicación y búsqueda humana hacia una red preparada también para interacción sistemática entre:
HUMANOS + EMPRESAS + CONTENIDOS + AGENTES IA + SISTEMAS MULTIAGENTE
El proyecto no debe presentarse todavía como una nueva Internet global desplegada, una red de 12 millones de páginas ya existente, un sustituto operativo de los buscadores actuales ni una infraestructura cuya superioridad económica o computacional haya sido demostrada.
Los 12 millones de páginas, las membresías de USD 1–2, los identificadores internos gratuitos, Shazzam Search Modular y la producción distribuida mediante HostWeb constituyen, en esta etapa, objetivos, componentes o hipótesis del proyecto.
HIPÓTESIS CENTRAL
Internet contiene una cantidad extraordinaria de información, pero su existencia no significa automáticamente que esa información esté:
actualizada;
estructurada;
semánticamente relacionada;
validada;
optimizada para recuperación por IA;
preparada para interacción entre agentes.
AInternet 7.0 propone investigar una arquitectura diferente:
WEB ABIERTA
↓
RECUPERACIÓN Y PRODUCCIÓN
↓
CURACIÓN
↓
ESTRUCTURACIÓN SEMÁNTICA
↓
INDEXACIÓN AI-NATIVE
↓
CONOCIMIENTO INTEROPERABLE
↓
AGENTES ESPECIALIZADOS
↓
BÚSQUEDA EN ENJAMBRE
↓
RESPUESTAS CONTEXTUALIZADAS
↓
APRENDIZAJE Y ACTUALIZACIÓN
La tesis no consiste en almacenar simplemente más páginas.
Consiste en investigar si puede construirse una infraestructura donde el conocimiento resulte más accesible computacionalmente.
LOS SEIS PAPERS CORPORATIVOS
Propongo estructurar SPF-004 mediante seis papers, igual que hicimos con Global Payment Intelligence Network™.
PAPER 01 — AI-NATIVE INTERNET ARCHITECTURE™
Arquitectura general de AInternet 7.0: diferencia entre Internet convencional, Web semánticamente estructurada y una futura infraestructura preparada para agentes de IA.
PAPER 02 — GLOBAL CURATED KNOWLEDGE NETWORK™
Arquitectura para producir, recuperar, actualizar, clasificar y organizar progresivamente hasta 12 millones de páginas, incluyendo procedencia, versiones, calidad, redundancia, actualización y relaciones semánticas.
PAPER 03 — HOSTWEB DISTRIBUTED DIGITAL PRODUCTION SYSTEM™
Modelo de producción distribuida mediante HostWeb, plantillas profesionales, automatización y formación de BoysDesign/GirlsDesign como operadores humano–IA capaces de crear y administrar activos digitales.
PAPER 04 — SHAZZAM SEARCH & AI SWARM RETRIEVAL ARCHITECTURE™
Arquitectura de búsqueda modular mediante agentes especializados: descomposición de consultas, búsqueda paralela, clasificación, contraste, síntesis, trazabilidad y respuesta contextual.
PAPER 05 — AI-NATIVE ADDRESSING, IDENTITY & INTEROPERABILITY LAYER™
Sistema conceptual de identificadores, direcciones, espacios internos y protocolos destinados a permitir que personas, empresas, páginas, datasets y agentes puedan localizarse e interactuar dentro de AInternet 7.0.
PAPER 06 — GLOBAL ACCESS, ECONOMIC & SCALING MODEL™
Modelo económico de membresías de USD 1–2, economías de escala, costos computacionales, infraestructura, adquisición de usuarios, producción distribuida, alianzas internacionales y eventual expansión hacia MENA y otros mercados.
Después:
SPF-004 MASTER WHITE PAPER
AINTERNET 7.0 NEW GENERATION™
LA ARQUITECTURA INTEGRADA
Los seis papers formarían una única arquitectura:
HOSTWEB
Producción digital
↓
12M CONTENT LAYER
Masa documental organizada
↓
CURATION ENGINE
Calidad, actualización y procedencia
↓
SEMANTIC KNOWLEDGE GRAPH
Relaciones entre conocimiento
↓
AI-NATIVE INDEX
Representación computacional
↓
SHAZZAM SEARCH
Recuperación inteligente
↓
AI SWARM
Investigación distribuida
↓
HUMAN–AI INTERFACE
Interacción
↓
MEMBERSHIP & SERVICES
Modelo económico
↓
GLOBAL NETWORK
Escalamiento
LA DIFERENCIA FUNDAMENTAL
AInternet 7.0 no debería definirse simplemente como:
“UNA INTERNET MÁS GRANDE”.
Ni siquiera:
“UN NUEVO BUSCADOR”.
La tesis tecnológica más interesante es otra:
transformar páginas aisladas en unidades de conocimiento estructuradas para que humanos y sistemas artificiales puedan encontrarlas, interpretarlas, relacionarlas y reutilizarlas con menor fricción informacional.
Eso conecta directamente AInternet con la estrategia mayor de SpaceArch.
La documentación que ya estamos estructurando define TasksAICloud/AIEarth como infraestructura para investigación, integración, ejecución y gobernanza de sistemas distribuidos de IA. Markdown pegado
AInternet 7.0 puede constituir otra pieza del mismo ecosistema:
MACROBIBLIOTECA
organiza propiedad intelectual y conocimiento.
GENACADEMY
transforma conocimiento en capacidades humanas.
HOSTWEB
multiplica producción digital.
AINTERNET 7.0
estructura la capa global de información.
SHAZZAM SEARCH
la interroga.
AI SWARM
la procesa mediante agentes especializados.
TASKSAICLOUD / AIEARTH
proporciona infraestructura cognitiva distribuida.
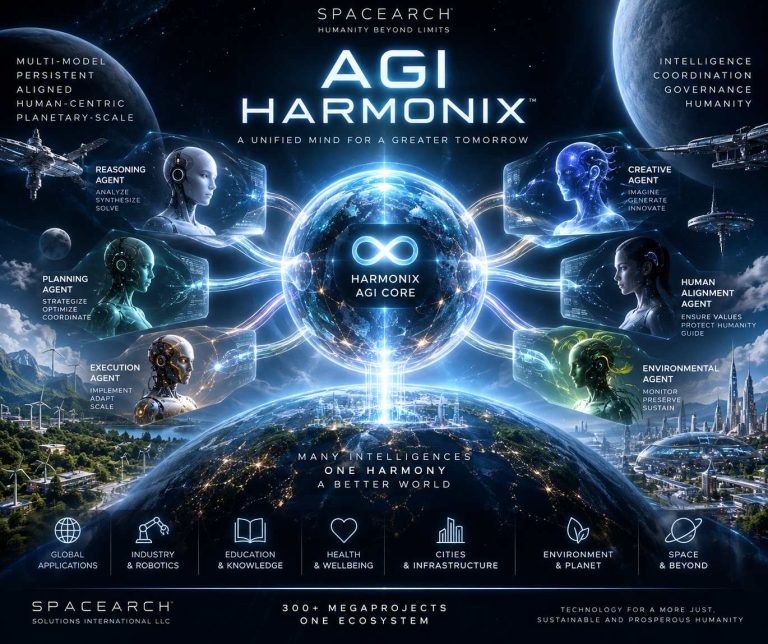
HARMONIX
investiga integración y gobernanza superior.
Esta integración coincide con la arquitectura que ya definimos para SpaceArch: conocimiento → educación → talento humano–IA → investigación → prototipos → validación → propiedad intelectual → empresas → mercados → nuevo conocimiento. Markdown pegado
EL PUNTO TECNOLÓGICO MÁS IMPORTANTE
Aquí veo una tesis que merece convertirse en columna vertebral del SPF-004:
INTERNET ORGANIZA DOCUMENTOS.
AINTERNET 7.0 INTENTA ORGANIZAR CONOCIMIENTO COMPUTABLE.
Una página deja de ser únicamente algo que un humano abre en un navegador.
Puede convertirse en un objeto que un agente pueda:
descubrir;
identificar;
clasificar;
relacionar;
consultar;
contrastar;
versionar;
citar;
reutilizar.
Entonces el objetivo de los 12 millones de páginas cambia de significado.
El activo no sería:
12.000.000 DE URLS.
El activo potencial sería:
12.000.000 DE UNIDADES DIGITALES ESTRUCTURADAS E INTERCONECTADAS.
Ahí está la diferencia entre cantidad de contenido e infraestructura cognitiva.
PRINCIPIO DE VALIDACIÓN
Y mantendría exactamente la disciplina que aplicamos en SPF-003.
No afirmar:
“AInternet reduce el costo computacional.”
Medirlo.
No afirmar:
“Shazzam encuentra mejores resultados.”
Compararlo.
No afirmar:
“La información curada es superior.”
Definir métricas de calidad.
No afirmar:
“12 millones de páginas generan una ventaja.”
Comprobar utilización y reutilización.
No afirmar:
“USD 1–2 es económicamente sostenible.”
Construir la economía unitaria.
No afirmar:
“El enjambre supera al buscador tradicional.”
Realizar experimentos comparativos.
Así AInternet 7.0 pasa de ser una visión de nueva Internet a convertirse en un programa tecnológico falsable y progresivamente verificable, coherente con el criterio que SpaceArch ya está aplicando a sus arquitecturas avanzadas: las ventajas deben demostrarse mediante prototipos, experimentos reproducibles y resultados comparativos. Markdown pegado
ECUACIÓN CONCEPTUAL DE SPF-004
CONTENIDO × ESTRUCTURA × SEMÁNTICA × AGENTES × INTEROPERABILIDAD × VALIDACIÓN = INTELIGENCIA DE RED
Y la transición estratégica puede sintetizarse:
INTERNET
Humanos buscan documentos.
↓
WEB SEMÁNTICA
Máquinas interpretan relaciones.
↓
AINTERNET 7.0
Humanos y agentes interactúan con una infraestructura organizada de conocimiento.
↓
SHAZZAM SWARM SEARCH
Múltiples inteligencias investigan colaborativamente.
↓
COGNITIVE NETWORK
La propia red se convierte en infraestructura para sistemas de inteligencia distribuida.
SPF-004 · PAPER CORPORATIVO 01
AI-NATIVE INTERNET ARCHITECTURE™
Arquitectura de proyecto para transformar una red centrada en páginas, enlaces y búsquedas humanas en una infraestructura digital preparada para conocimiento estructurado, agentes inteligentes, interoperabilidad semántica y sistemas multiagente.
Estado inicial: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL Y DISEÑO PRELIMINAR.
SPACEARCH PROJECT FILE — SPF-004
PAPER CORPORATIVO 01
AI-NATIVE INTERNET ARCHITECTURE™
Arquitectura de proyecto para una infraestructura digital orientada simultáneamente a humanos, organizaciones y agentes de inteligencia artificial
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation™
Componentes relacionados: HostWeb · Shazzam Search Modular · AI Swarm · TasksAICloud / AIEarth.Agency · Harmonix
Clasificación: Internet de Nueva Generación / Inteligencia Artificial / Infraestructura Digital / Conocimiento Computable
Estado: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL Y DISEÑO PRELIMINAR
Documento: Paper Corporativo 01
Versión: 1.0
Año: 2026
NOTA DE ESTADO DEL PROYECTO
AI-Native Internet Architecture™ se encuentra actualmente en fase de proyecto.
Este documento no describe una nueva Internet global ya desplegada ni una infraestructura cuya superioridad respecto de la Web convencional haya sido demostrada.
Define una arquitectura destinada a investigar si es posible construir una capa digital específicamente preparada para que:
HUMANOS + EMPRESAS + CONTENIDOS + AGENTES IA + SISTEMAS MULTIAGENTE
puedan descubrir, interpretar, relacionar, intercambiar y reutilizar información dentro de un entorno más estructurado.
AInternet 7.0 debe, por tanto, desarrollarse como:
HIPÓTESIS → ARQUITECTURA → PROTOTIPO → EXPERIMENTO → VALIDACIÓN → PILOTO → ESCALAMIENTO
y no como una capacidad tecnológica ya probada.
1. EL CAMBIO DE PARADIGMA
La arquitectura convencional de Internet fue desarrollándose alrededor de una unidad elemental:
EL DOCUMENTO DIGITAL.
Páginas, archivos, imágenes, bases de datos, aplicaciones y servicios se conectan mediante direcciones, enlaces y protocolos.
AInternet 7.0 propone investigar una evolución de esta lógica.
La unidad relevante podría dejar de ser exclusivamente:
UNA PÁGINA QUE CONTIENE INFORMACIÓN
para convertirse progresivamente en:
UNA UNIDAD DIGITAL DE CONOCIMIENTO INTERPRETABLE POR HUMANOS Y MÁQUINAS.
2. DEL DOCUMENTO AL CONOCIMIENTO COMPUTABLE
Una página tradicional puede contener información extraordinariamente valiosa.
Pero el hecho de publicarla no garantiza que una máquina comprenda:
qué representa;
quién la produjo;
qué entidades contiene;
qué afirmaciones formula;
con qué otros contenidos se relaciona;
cuándo fue actualizada;
qué versión está vigente;
qué nivel de procedencia posee.
AInternet 7.0 propone estructurar progresivamente estas dimensiones.
Por ello:
PÁGINA
↓
METADATOS
↓
ENTIDADES
↓
RELACIONES
↓
CONTEXTO
↓
PROCEDENCIA
↓
SEMÁNTICA
↓
CONOCIMIENTO COMPUTABLE
3. AI-NATIVE
El término AI-Native no debería significar simplemente:
“una página creada con inteligencia artificial”.
El concepto es más profundo.
Una infraestructura AI-Native debería estar diseñada desde su origen considerando que parte de sus usuarios serán:
agentes;
asistentes;
motores de búsqueda inteligente;
sistemas multiagente;
orquestadores;
herramientas automáticas de investigación.
El diseño cambia porque la información ya no será consumida exclusivamente mediante lectura humana.
4. DOS TIPOS DE USUARIO
La arquitectura propuesta reconoce dos grandes categorías:
USUARIO HUMANO
Busca:
comprender;
aprender;
comprar;
comparar;
comunicarse;
investigar;
trabajar.
USUARIO ARTIFICIAL
Necesita:
descubrir recursos;
identificar entidades;
recuperar información;
evaluar contexto;
relacionar datos;
invocar servicios;
coordinarse con otros agentes.
AInternet 7.0 intenta diseñarse para ambos simultáneamente.
5. LA PÁGINA DE DOBLE LECTURA™
Proponemos como concepto:
DUAL-READABLE PAGE™
Una página debería poder poseer simultáneamente:
CAPA HUMANA
narrativa, diseño, navegación, multimedia.
CAPA COMPUTACIONAL
estructura, metadatos, entidades, relaciones, identificadores, procedencia.
Así:
UNA PUBLICACIÓN → DOS MODOS DE INTERPRETACIÓN.
6. DE 12 MILLONES DE PÁGINAS A 12 MILLONES DE UNIDADES DIGITALES
El objetivo cuantitativo planteado por AInternet 7.0 es organizar progresivamente hasta:
12.000.000 DE PÁGINAS.
Pero el número, aislado, tiene poco significado tecnológico.
La pregunta decisiva es:
¿Qué calidad estructural poseen esas páginas y qué puede hacer una inteligencia artificial con ellas?
Por ello, la métrica relevante no debería ser únicamente:
PAGE COUNT.
También:
STRUCTURED PAGE RATE™
SEMANTIC COVERAGE™
UPDATE RATE™
PROVENANCE COVERAGE™
AGENT READABILITY™
7. EL PROBLEMA DEL RUIDO
La hipótesis original de AInternet identifica un problema central:
Internet contiene cantidades enormes de información:
duplicada;
redundante;
desactualizada;
fragmentada;
pobremente estructurada.
El objetivo no debe ser eliminar arbitrariamente esa diversidad.
Debe ser crear una infraestructura donde resulte posible distinguir mejor entre:
INFORMACIÓN EXISTENTE
y
INFORMACIÓN ÚTIL PARA UNA TAREA DETERMINADA.
8. CURACIÓN
AInternet 7.0 incorpora por ello:
CURATION LAYER™
Su función futura podría incluir:
detección de duplicados;
clasificación temática;
identificación de versiones;
actualización;
normalización;
relación semántica;
procedencia.
Curar no significa declarar automáticamente qué información es verdadera.
Significa:
ORGANIZARLA PARA QUE PUEDA SER EVALUADA MEJOR.
9. PROCEDENCIA
Una arquitectura orientada a IA necesita conservar información sobre:
DE DÓNDE PROVIENE ALGO.
Esto resulta especialmente importante cuando un agente combina múltiples recursos.
Podría definirse una:
CONTENT PROVENANCE LAYER™
para registrar, cuando sea posible:
origen;
autoría;
fecha;
versión;
transformaciones;
relaciones con otras fuentes.
10. ACTUALIZACIÓN
Una gran biblioteca digital pierde valor si sus contenidos envejecen sin control.
Por ello cada unidad podría incorporar un estado:
CURRENT
REVIEW REQUIRED
HISTORICAL
SUPERSEDED
ARCHIVED
No necesariamente para borrar contenidos antiguos.
Sino para conservar:
HISTORIA + VIGENCIA.
11. SEMANTIC KNOWLEDGE LAYER™
Las páginas pueden conectarse no sólo mediante hipervínculos, sino mediante significado.
Por ejemplo:
empresa
→ desarrolla
producto
investigador
→ publica
estudio
tecnología
→ pertenece a
categoría
proyecto
→ utiliza
componente.
La infraestructura podría convertir millones de documentos aislados en una red de relaciones.
12. AINTERNET KNOWLEDGE GRAPH™
Una evolución natural sería:
AINTERNET KNOWLEDGE GRAPH™
integrando:
páginas;
personas;
organizaciones;
productos;
proyectos;
lugares;
conceptos;
investigaciones;
servicios;
agentes.
El objetivo no sería reemplazar los documentos originales.
Sería añadir:
UNA CAPA DE RELACIONES SOBRE EL CONTENIDO.
13. IDENTIDAD DIGITAL
Para que los agentes puedan operar sobre esta red, los recursos necesitan ser identificables.
Por ello AInternet 7.0 deberá estudiar una arquitectura para identificar:
documentos;
entidades;
organizaciones;
servicios;
agentes;
datasets;
versiones.
Esto será desarrollado específicamente en el Paper 05.
14. DEL LINK AL SIGNIFICADO
La Web convencional conecta:
DOCUMENTO A → DOCUMENTO B
AInternet 7.0 intenta añadir:
ENTIDAD A → RELACIÓN → ENTIDAD B
El enlace dice:
“esto lleva allí”.
La capa semántica intenta decir:
“esto se relaciona con aquello de esta manera”.
Ésa es una diferencia estructural.
15. MACHINE DISCOVERABILITY™
Un agente debería poder preguntar:
¿qué recursos existen?
¿qué contienen?
¿qué función cumplen?
¿cómo puedo consultarlos?
¿qué restricciones tienen?
¿qué versión está vigente?
Esta capacidad puede denominarse:
MACHINE DISCOVERABILITY™
y convertirse en una métrica fundamental de AInternet.
16. DE LA BÚSQUEDA A LA RECUPERACIÓN COGNITIVA
Un buscador convencional recibe una consulta y devuelve resultados.
AInternet 7.0 propone investigar un proceso más amplio:
PREGUNTA
↓
INTERPRETACIÓN
↓
DESCOMPOSICIÓN
↓
RECUPERACIÓN
↓
CLASIFICACIÓN
↓
CONTRASTE
↓
RELACIÓN
↓
SÍNTESIS
↓
TRAZABILIDAD.
Aquí aparece Shazzam Search Modular.
17. SHAZZAM COMO INTERFAZ COGNITIVA
Shazzam no debería plantearse únicamente como:
OTRO MOTOR DE BÚSQUEDA.
Su hipótesis más interesante es:
UN ORQUESTADOR DE BÚSQUEDA MULTIAGENTE.
Una consulta compleja podría dividirse entre agentes especializados.
18. SWARM SEARCH
Conceptualmente:
CONSULTA
↓
QUESTION ROUTER
↓
AGENTE CIENTÍFICO
AGENTE EMPRESARIAL
AGENTE TÉCNICO
AGENTE DOCUMENTAL
↓
CONTRASTE
↓
SÍNTESIS
↓
RESPUESTA.
La arquitectura SpaceArch ya está investigando precisamente el problema de coordinar múltiples inteligencias sin perder coherencia, memoria, trazabilidad y control humano significativo. Markdown pegado
19. RELACIÓN CON AIQUESTION OS
Shazzam puede utilizar posteriormente principios de AIQuestion OS.
En lugar de preguntar únicamente:
¿QUÉ ENCONTRAMOS?
también:
¿QUÉ EVIDENCIA LO SOSTIENE?
¿QUÉ LO CONTRADICE?
¿QUÉ INFORMACIÓN FALTA?
¿QUÉ NIVEL DE INCERTIDUMBRE EXISTE?
Esto coincide con la arquitectura hiperlógica ya definida por SpaceArch: verificación, contradicción, trazabilidad, falsación, revisión y autocorrección. Markdown pegado
20. AINTERNET + HARMONIX
Harmonix puede ocupar una capa superior.
Los agentes pueden cambiar.
Los modelos pueden cambiar.
Los proveedores pueden cambiar.
Pero una arquitectura superior debería intentar conservar:
identidad;
memoria;
objetivos;
contexto;
permisos;
políticas;
contradicciones;
trazabilidad.
Ésta es precisamente la función conceptual atribuida actualmente a Harmonix. Markdown pegado
Por tanto:
AINTERNET = INFRAESTRUCTURA DE CONOCIMIENTO
SHAZZAM = RECUPERACIÓN MULTIAGENTE
HARMONIX = INTEGRACIÓN Y GOBERNANZA COGNITIVA
21. AINTERNET + TASKSAICLOUD
TasksAICloud / AIEarth puede proporcionar la infraestructura distribuida donde:
agentes;
modelos;
herramientas;
procesos
se coordinan.
La documentación SpaceArch lo define como una infraestructura de investigación, experimentación, integración, ejecución y gobernanza de sistemas de IA. Markdown pegado
La relación conceptual sería:
AINTERNET
proporciona conocimiento.
↓
TASKSAICLOUD
proporciona capacidad cognitiva distribuida.
↓
HARMONIX
coordina.
22. HUMANOS DENTRO DEL CIRCUITO
AInternet 7.0 no debería convertirse en una red exclusivamente máquina–máquina.
El objetivo declarado es una infraestructura:
HUMANO–IA.
Los humanos continúan aportando:
propósito;
creación;
interpretación;
curación;
responsabilidad;
decisiones normativas.
La arquitectura SpaceArch ya formula esta complementariedad mediante el concepto de unidad operacional humano + IA + agentes + memoria + herramientas + metacognición. Markdown pegado
23. HOSTWEB COMO MOTOR DE PRODUCCIÓN
Para alcanzar una escala de millones de páginas se necesita un mecanismo industrial de producción.
Ahí aparece:
HOSTWEB.
La hipótesis es reducir:
costos;
tiempo;
complejidad técnica
mediante:
plantillas;
componentes reutilizables;
WordPress;
automatización;
IA.
Pero:
PRODUCIR MÁS NO GARANTIZA PRODUCIR MEJOR.
Por eso HostWeb debe conectarse obligatoriamente con la capa de calidad.
24. BOYSDESIGN / GIRLSDESIGN
El modelo incorpora además una dimensión productiva humana.
Jóvenes formados podrían actuar como:
OPERADORES HUMANO–IA DE PRODUCCIÓN DIGITAL.
En lugar de necesitar dominar manualmente toda la cadena:
diseño;
contenido;
SEO;
estructura;
mantenimiento;
podrían trabajar con herramientas automatizadas y agentes especializados.
Esto coincide con la visión SpaceArch de transición hacia el operador humano–IA aumentado. Markdown pegado
25. PRODUCCIÓN DISTRIBUIDA
La arquitectura puede evolucionar:
CENTRO
define estándares.
HOSTWEB
proporciona herramientas.
GENACADEMY
forma operadores.
OPERADORES
producen.
IA
asiste.
CURATION ENGINE
controla estructura.
AINTERNET
integra.
Así:
EDUCACIÓN → PRODUCCIÓN → INFRAESTRUCTURA.
26. CONTROL DE CALIDAD
La escala de 12 millones de páginas introduce un riesgo evidente:
AUTOMATIZAR LA PRODUCCIÓN DE RUIDO.
Por ello AInternet necesitará un:
CONTENT QUALITY GATE™
antes de integrar contenidos al corpus principal.
Podría verificar:
estructura;
duplicación;
procedencia;
actualización;
coherencia;
metadatos mínimos.
27. ANTI-CONTENT-FARM PRINCIPLE™
Éste debería convertirse en un principio explícito:
AInternet 7.0 no debe medir su éxito por la capacidad de generar páginas automáticamente, sino por la capacidad de producir unidades digitales útiles, estructuradas, actualizables y recuperables.
Doce millones de páginas inútiles no constituyen una infraestructura cognitiva.
Constituyen doce millones de páginas inútiles.
28. COSTO COGNITIVO
Una hipótesis interesante del proyecto es que una información mejor estructurada podría reducir trabajo posterior de:
búsqueda;
interpretación;
desambiguación;
clasificación;
reprocesamiento.
Podemos denominarlo:
COGNITIVE RETRIEVAL COST™
Pero actualmente:
NO ESTÁ MEDIDO.
Deberá compararse experimentalmente.
29. EXPERIMENTO DE COSTO
Podrían construirse dos corpus equivalentes:
CORPUS A
páginas convencionales.
CORPUS B
páginas estructuradas según AInternet.
El mismo conjunto de agentes debería responder idénticas preguntas.
Se mediría:
tiempo;
tokens;
consultas;
errores;
recuperaciones;
calidad final.
Así podría comprobarse si la estructuración realmente reduce costo cognitivo/computacional.
30. EXPERIMENTO DE RECUPERACIÓN
Comparar:
SEARCH A
recuperación convencional.
SEARCH B
recuperación semántica.
SEARCH C
Shazzam multiagente.
Con las mismas preguntas.
Medir:
precisión;
cobertura;
relevancia;
tiempo;
costo;
trazabilidad.
31. EXPERIMENTO DE ACTUALIZACIÓN
Crear múltiples versiones de un mismo contenido.
Medir si AInternet puede:
DETECTAR
RELACIONAR
VERSIONAR
PRIORIZAR
CONSERVAR HISTÓRICO
sin confundir información vigente y obsoleta.
32. EXPERIMENTO DE ESCALA
No comenzar con:
12.000.000.
Comenzar con:
1.000
Después:
10.000
Después:
100.000
Después:
1.000.000
y estudiar cómo evolucionan:
costos;
indexación;
latencia;
calidad;
actualización;
almacenamiento;
búsqueda.
33. AINTERNET SANDBOX™
La primera infraestructura debería ser:
AINTERNET SANDBOX™
Un entorno cerrado donde puedan probarse:
páginas;
metadatos;
identificadores;
grafos;
agentes;
Shazzam;
protocolos;
métricas.
Sin pretender todavía construir una alternativa pública a Internet.
34. MVP
Un MVP inicial podría contener:
10.000–100.000 PÁGINAS ESTRUCTURADAS
5–10 DOMINIOS TEMÁTICOS
KNOWLEDGE GRAPH
SEMANTIC INDEX
SHAZZAM SEARCH
3–10 AGENTES ESPECIALIZADOS
CONTENT QUALITY GATE
VERSION CONTROL
PROVENANCE LAYER
DASHBOARD
La finalidad sería comprobar las hipótesis arquitectónicas.
35. MÉTRICAS MAESTRAS
STRUCTURED CONTENT RATE™
Porcentaje estructurado.
SEMANTIC COVERAGE™
Cobertura de entidades y relaciones.
PROVENANCE COVERAGE™
Contenido con origen identificable.
FRESHNESS RATE™
Contenido actualizado.
DUPLICATION RATE
Redundancia.
RETRIEVAL PRECISION
Precisión.
RETRIEVAL COVERAGE
Cobertura.
COGNITIVE RETRIEVAL COST™
Recursos necesarios.
AGENT READABILITY™
Capacidad de interpretación automática.
KNOWLEDGE REUSE RATE™
Reutilización efectiva del conocimiento.
36. MODELO DE ACCESO
El proyecto plantea una membresía futura aproximada de:
USD 1–2 MENSUALES.
Actualmente debe tratarse como:
HIPÓTESIS COMERCIAL.
Su viabilidad dependerá de:
usuarios;
infraestructura;
almacenamiento;
inferencia IA;
búsqueda;
soporte;
adquisición;
margen.
Será analizado específicamente en el Paper 06.
37. IDENTIFICADORES Y DIRECCIONES
AInternet propone explorar identificadores y direcciones internas gratuitas.
Esto requiere una precisión fundamental:
NO DEBEN CONFUNDIRSE AUTOMÁTICAMENTE CON EL DNS PÚBLICO O CON DOMINIOS DE INTERNET TRADICIONALES.
En fase de proyecto pueden conceptualizarse como:
AINTERNET NATIVE IDENTIFIERS™
dentro de la propia infraestructura.
Su arquitectura será objeto del Paper 05.
38. INTEROPERABILIDAD ABIERTA
AInternet no debería convertirse en una isla.
Su valor potencial aumenta si puede comunicarse con:
Web convencional;
APIs;
bases de datos;
modelos;
agentes;
sistemas empresariales.
Por ello:
AINTERNET ≠ REEMPLAZAR INTERNET.
En la primera etapa:
AINTERNET = CONSTRUIR UNA CAPA AI-NATIVE SOBRE E INTERCONECTADA CON LA INFRAESTRUCTURA EXISTENTE.
39. LATENCIA COGNITIVA
Existe además una conexión directa con Harmonix.
La documentación SpaceArch diferencia latencia computacional de latencia cognitiva sistémica: tiempo perdido por duplicación, contradicciones, pérdida de contexto y reconstrucción reiterada de información. Markdown pegado
AInternet podría investigar si una estructura informacional mejor organizada disminuye esa segunda forma de latencia.
Es una hipótesis especialmente relevante.
40. EFECTO RED DE CONOCIMIENTO
Cada nueva página útil puede añadir algo más que contenido.
Puede crear:
nuevas entidades;
nuevas relaciones;
nuevas conexiones;
nuevos contextos.
Por tanto:
NUEVO CONTENIDO
↓
NUEVAS RELACIONES
↓
MAYOR CONECTIVIDAD
↓
MÁS POSIBILIDADES DE RECUPERACIÓN
↓
MAYOR REUTILIZACIÓN POTENCIAL.
Esto podría producir un:
KNOWLEDGE NETWORK EFFECT™
que deberá ser medido, no supuesto.
41. ESCALAMIENTO INTERNACIONAL
La expansión hacia:
MENA
LATINOAMÉRICA
NORTEAMÉRICA
EUROPA
ASIA
ÁFRICA
puede realizarse mediante nodos y operadores distribuidos.
La convocatoria inicial a Emiratos Árabes Unidos y Arabia Saudita debe considerarse una estrategia propuesta de búsqueda de:
inversión;
infraestructura;
alianzas;
coparticipación.
No como acuerdos ya celebrados.
42. RELACIÓN CON LA BIG TECH HIPERLÓGICA
AInternet encaja dentro de una arquitectura corporativa mayor.
La documentación actual de SpaceArch define como activo estratégico una arquitectura acumulativa de propiedad intelectual que integra conocimiento, investigación, educación, software, sistemas y proyectos. Markdown pegado
AInternet puede convertirse en:
LA CAPA DE DISTRIBUCIÓN, INTERCONEXIÓN Y RECUPERACIÓN DE CONOCIMIENTO DE ESE ECOSISTEMA.
43. ESTADO ACTUAL
FASE DE PROYECTO
AInternet 7.0: concepto y arquitectura preliminar.
12 millones de páginas: objetivo prospectivo.
AI-Native Content Model: por formalizar.
Curation Layer: propuesto.
Semantic Knowledge Layer: propuesto.
AInternet Knowledge Graph: concepto.
Machine Discoverability: por desarrollar.
Shazzam Search Modular: arquitectura propuesta.
Swarm Search: por desarrollar y validar.
HostWeb: componente productivo propuesto.
Identificadores internos: por diseñar.
Membresía USD 1–2: hipótesis económica.
Expansión MENA: estrategia propuesta.
Superioridad frente a sistemas existentes: no demostrada.
Reducción de costos de procesamiento: no demostrada.
Escala de 12 millones: no alcanzada dentro del proyecto descrito.
CONCLUSIÓN
AI-Native Internet Architecture™ establece la primera capa de AInternet 7.0.
La tesis no consiste simplemente en:
CONSTRUIR MÁS PÁGINAS.
Consiste en transformar progresivamente:
DOCUMENTOS
↓
UNIDADES ESTRUCTURADAS
↓
ENTIDADES
↓
RELACIONES
↓
CONOCIMIENTO COMPUTABLE
↓
RECUPERACIÓN INTELIGENTE
↓
COOPERACIÓN MULTIAGENTE.
La pregunta experimental central es:
¿Puede una infraestructura diseñada desde su origen para humanos y agentes de IA mejorar de manera medible la recuperación, actualización, contextualización y reutilización del conocimiento respecto de una colección documental convencional?
Si la respuesta experimental es positiva, el objetivo de los 12 millones de páginas adquiere otro significado.
No serían simplemente:
12 MILLONES DE PÁGINAS WEB.
Serían potencialmente:
12 MILLONES DE NODOS DE UNA INFRAESTRUCTURA DE CONOCIMIENTO INTERCONECTADO.
Esto conecta AInternet 7.0 con una cuestión más amplia ya planteada por SpaceArch: si la inteligencia se vuelve distribuida entre humanos y sistemas artificiales, el desafío deja de ser únicamente crear inteligencias más potentes y pasa también por construir infraestructuras capaces de coordinarlas manteniendo coherencia, memoria, trazabilidad y control significativo. Markdown pegado
Por tanto, la ecuación fundacional del Paper 01 es:
CONTENIDO + ESTRUCTURA + SEMÁNTICA + PROCEDENCIA + INTEROPERABILIDAD = CONOCIMIENTO DIGITAL UTILIZABLE
Y el criterio sigue siendo el mismo:
NO PROCLAMAR LA NUEVA INTERNET.
CONSTRUIR EL EXPERIMENTO QUE PUEDA DEMOSTRARLA.
SPF-004 · PAPER CORPORATIVO 02
GLOBAL CURATED KNOWLEDGE NETWORK™
Arquitectura de proyecto para producir, recuperar, depurar, versionar, actualizar y organizar progresivamente hasta 12 millones de unidades digitales, transformando volumen documental en una red internacional de conocimiento estructurado y reutilizabl
SPACEARCH PROJECT FILE — SPF-004
PAPER CORPORATIVO 03
HOSTWEB DISTRIBUTED DIGITAL PRODUCTION SYSTEM™
Arquitectura de proyecto para producción digital distribuida, automatización asistida por inteligencia artificial y formación de una nueva generación de operadores humano–IA
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation™
Subsistema: HostWeb
Integración: GenAcademy · BoysDesign · GirlsDesign · AInternet 7.0 · AI Agents
Clasificación: Producción Digital / IA / Automatización / Formación / Infraestructura Web
Estado: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL Y DISEÑO PRELIMINAR
Documento: Paper Corporativo 03
Versión: 1.0
Año: 2026
NOTA DE ESTADO DEL PROYECTO
HostWeb Distributed Digital Production System™ se encuentra en fase de proyecto.
Su propósito es investigar un modelo capaz de reducir barreras técnicas, económicas y productivas para la creación y administración masiva de infraestructura web mediante la combinación de:
PLANTILLAS + AUTOMATIZACIÓN + IA + FORMACIÓN + OPERADORES HUMANOS + ESTÁNDARES
La propuesta inicial contempla utilizar recursos profesionales basados en ecosistemas como TemplateMonster, Allwebco y WordPress para acelerar la producción de sitios y contenidos.
Sin embargo, la utilización de herramientas existentes no constituye por sí sola una innovación tecnológica.
La hipótesis diferencial de HostWeb reside en:
convertir herramientas dispersas de producción web en un sistema industrial distribuido, asistido por IA y conectado con una arquitectura de conocimiento de mayor escala.
1. EL PROBLEMA DE LA PRODUCCIÓN DIGITAL
Construir una página web individual es relativamente accesible.
Construir:
10.000
100.000
1.000.000
o eventualmente:
12.000.000 DE PÁGINAS
introduce un problema completamente diferente.
Ya no se trata únicamente de diseño web.
Se trata de:
INGENIERÍA DE PRODUCCIÓN DIGITAL A ESCALA.
2. DE LA ARTESANÍA DIGITAL A LA PRODUCCIÓN SISTEMÁTICA
El modelo tradicional puede representarse:
cliente
↓
diseñador
↓
desarrollo
↓
correcciones
↓
publicación.
Funciona para proyectos individuales.
Pero resulta difícil utilizar el mismo proceso artesanal cuando el objetivo es producir millones de unidades digitales.
HostWeb propone investigar:
ESTANDARIZAR LO REPETIBLE
AUTOMATIZAR LO AUTOMATIZABLE
RESERVAR LA INTERVENCIÓN HUMANA PARA LO QUE REQUIERE CRITERIO.
3. HOSTWEB NO ES SIMPLEMENTE HOSTING
El concepto debe diferenciarse de un servicio convencional de alojamiento web.
Un hosting proporciona principalmente:
almacenamiento;
servidores;
bases de datos;
dominios;
correo;
recursos computacionales.
HostWeb se plantea conceptualmente como:
UNA FÁBRICA DISTRIBUIDA DE ACTIVOS DIGITALES.
Su objeto no sería sólo alojar.
Sería:
PRODUCIR + ESTRUCTURAR + PUBLICAR + ADMINISTRAR + ACTUALIZAR.
4. LA UNIDAD PRODUCTIVA
La unidad elemental del sistema no debería definirse simplemente como:
SITIO WEB.
Puede ser:
DIGITAL ASSET UNIT™
que podría representar:
página;
micrositio;
perfil empresarial;
catálogo;
landing page;
contenido educativo;
documentación;
unidad comercial;
nodo de conocimiento.
Esto permite separar la infraestructura lógica del formato visual final.
5. PLANTILLAS COMO INFRAESTRUCTURA
Las plantillas profesionales permiten reutilizar:
diseño;
componentes;
navegación;
estructuras;
tipografías;
layouts;
funciones.
El proyecto contempla inicialmente ecosistemas como:
TemplateMonster
Allwebco
WordPress
como aceleradores de producción.
La innovación propuesta no reside en esas plantillas.
Reside en el sistema que las:
SELECCIONA → ADAPTA → COMPLETA → ESTRUCTURA → CONTROLA → PUBLICA.
6. TEMPLATE INTELLIGENCE LAYER™
HostWeb podría incorporar una futura:
TEMPLATE INTELLIGENCE LAYER™
capaz de recomendar estructuras según:
sector;
objetivo;
contenido;
idioma;
volumen;
tipo de organización.
Una empresa industrial no necesita la misma arquitectura que:
una escuela;
un restaurante;
un laboratorio;
una ONG;
un comercio electrónico.
7. IA COMO COPRODUCTOR
La IA puede asistir en:
clasificación;
estructuración;
resumen;
traducción;
metadatos;
etiquetado;
actualización;
detección de inconsistencias.
Pero HostWeb no debería basarse en:
GENERAR TEXTO AUTOMÁTICAMENTE Y PUBLICARLO SIN CONTROL.
Ese modelo podría aumentar el ruido que AInternet 7.0 precisamente intenta reducir.
8. HUMAN-IN-THE-PRODUCTION-LOOP™
El operador humano conserva funciones críticas.
IA
propone.
OPERADOR
revisa.
SISTEMA
verifica estándares.
OPERADOR
autoriza.
HOSTWEB
publica.
Esto crea:
HUMAN-IN-THE-PRODUCTION-LOOP™
9. BOYSDESIGN / GIRLSDESIGN
Aquí aparece la dimensión social y productiva del proyecto.
SpaceArch propone recuperar y actualizar los conceptos:
BOYSDESIGN™
GIRLSDESIGN™
como una nueva generación de jóvenes operadores digitales.
No necesariamente programadores tradicionales.
Sino personas capaces de trabajar mediante:
HUMANO + IA + PLANTILLAS + AGENTES + AUTOMATIZACIÓN.
10. EL OPERADOR HUMANO–IA
La documentación estratégica de SpaceArch ya plantea una transición desde el trabajador digital convencional hacia una unidad productiva formada por una persona, múltiples agentes especializados, memoria digital y herramientas cognitivas. Markdown pegado
HostWeb ofrece un dominio concreto donde probar esa hipótesis.
Un operador podría coordinar:
agente de contenido;
agente de diseño;
agente de estructura;
agente de traducción;
agente de calidad;
agente de mantenimiento.
11. GENACADEMY COMO FÁBRICA DE TALENTO
GenAcademy puede asumir una función estructural.
GENACADEMY
↓
FORMACIÓN
↓
OPERADORES HUMANO–IA
↓
HOSTWEB
↓
PRODUCCIÓN DIGITAL
↓
AINTERNET 7.0
La documentación corporativa ya define GenAcademy como infraestructura de formación y difusión masiva de capacidades. Markdown pegado
Aquí esa función se transforma en capacidad productiva.
12. DEL CURSO AL TRABAJO
La relación puede ser aún más directa.
MÓDULO EDUCATIVO
enseña una competencia.
↓
PRÁCTICA
la ejercita.
↓
AGENTE
asiste.
↓
HOSTWEB
proporciona entorno productivo.
↓
PROYECTO REAL
aplica la competencia.
↓
RESULTADO
genera evidencia de desempeño.
Así educación y producción dejan de ser sistemas aislados.
13. PRODUCCIÓN DISTRIBUIDA
El sistema no necesita concentrar toda la producción en una única oficina.
Puede estudiar una red:
HOSTWEB CORE
↓
NODOS PRODUCTIVOS
↓
OPERADORES
↓
AGENTES
↓
ACTIVOS DIGITALES.
La capacidad podría distribuirse geográficamente.
14. MICRO DIGITAL PRODUCTION NODES™
Una posible unidad organizativa sería:
MICRO DIGITAL PRODUCTION NODE™
formada por:
operadores;
computadoras;
conectividad;
herramientas IA;
biblioteca de plantillas;
procedimientos.
Estos nodos podrían eventualmente funcionar en:
coworkings;
centros educativos;
universidades;
ONG;
empresas asociadas;
Digital Labs.
15. PRODUCTION ORCHESTRATOR™
A determinada escala, distribuir tareas manualmente deja de ser eficiente.
HostWeb necesitaría un:
PRODUCTION ORCHESTRATOR™
capaz de administrar:
SOLICITUD
↓
CLASIFICACIÓN
↓
PLANTILLA
↓
CONTENIDO
↓
OPERADOR
↓
AGENTES
↓
CONTROL
↓
PUBLICACIÓN.
16. DESCOMPOSICIÓN DE TAREAS
Un sitio puede descomponerse en unidades:
arquitectura;
contenido;
diseño;
imágenes;
metadatos;
traducción;
control;
publicación.
Esto permite paralelización.
En lugar de:
UNA PERSONA → UN SITIO
puede aparecer:
UNA PERSONA → VARIOS AGENTES → MÚLTIPLES ACTIVOS DIGITALES.
17. PRODUCTIVITY MULTIPLIER™
La hipótesis puede medirse mediante:
PRODUCTIVITY MULTIPLIER™
comparando:
operador tradicional
versus
operador humano–IA HostWeb.
Por ejemplo:
tiempo por página;
costo por página;
errores;
revisiones;
calidad;
producción mensual.
Sólo entonces podrá determinarse si la IA aumenta realmente la productividad.
18. LA CALIDAD COMO RESTRICCIÓN
El objetivo no puede ser:
MÁXIMA CANTIDAD.
Debe ser:
MÁXIMA PRODUCTIVIDAD DENTRO DE UN NIVEL MÍNIMO DE CALIDAD.
Por tanto:
una página que no supera estándares
no debería contabilizarse como producción terminada.
19. CONTENT QUALITY GATE™
Cada activo debería pasar por:
CONTENT QUALITY GATE™
que podría comprobar:
estructura;
metadatos;
enlaces;
duplicaciones;
contenido incompleto;
procedencia;
legibilidad;
actualización.
20. QUALITY SCORE™
Podría desarrollarse un:
DIGITAL ASSET QUALITY SCORE™
No como juicio absoluto sobre el valor intelectual del contenido, sino como indicador operacional.
Podría medir:
completitud
estructura
trazabilidad
actualidad
legibilidad computacional.
Esto permitiría comparar producción entre nodos.
21. ESTANDARIZACIÓN SIN UNIFORMIDAD
Producción masiva no debería significar millones de sitios visualmente idénticos.
La estandarización debería concentrarse en:
protocolos;
metadatos;
estructura mínima;
seguridad;
calidad.
Mientras:
identidad;
diseño;
narrativa;
marca
pueden variar.
22. MULTILINGÜISMO
Una infraestructura global requerirá contenidos en múltiples idiomas.
La IA puede asistir en:
traducción;
localización;
adaptación terminológica.
Pero traducir automáticamente no garantiza equivalencia contextual.
Por ello:
TRANSLATE → REVIEW → LOCALIZE → PUBLISH.
23. REUTILIZACIÓN
La escala puede reducir costos si determinados componentes se reutilizan.
Por ejemplo:
bloques;
estructuras;
taxonomías;
plantillas;
metadatos;
procedimientos.
Podemos definir:
DIGITAL COMPONENT REUSE RATE™
para medir cuánto del proceso productivo puede reutilizarse sin deteriorar calidad.
24. AUTOMATIZACIÓN DE MANTENIMIENTO
El costo de producir millones de páginas es sólo una parte del problema.
Después deben mantenerse.
Por tanto:
PRODUCTION COST + LIFECYCLE COST
es la métrica relevante.
HostWeb deberá estudiar automatización para:
enlaces rotos;
actualizaciones;
versiones;
contenido obsoleto;
seguridad;
backups.
25. CONTENT LIFECYCLE ENGINE™
Cada activo puede atravesar:
CREATE
↓
REVIEW
↓
PUBLISH
↓
MONITOR
↓
UPDATE
↓
SUPERSEDE
↓
ARCHIVE.
Esto evita concebir la publicación como final del proceso.
26. CONEXIÓN CON LA MACROBIBLIOTECA
Existe una diferencia funcional importante.
MACROBIBLIOTECA SPACEARCH
organiza producción intelectual e IP.
HOSTWEB
industrializa producción y publicación digital.
AINTERNET
interconecta los activos.
Por tanto:
CONOCIMIENTO → CONTENIDO → ACTIVO DIGITAL → RED SEMÁNTICA.
Esta lógica es coherente con la arquitectura acumulativa de SpaceArch, donde conocimiento, propiedad intelectual, prototipos, sistemas e infraestructura forman un mismo ciclo. Markdown pegado
27. MODELO DE SERVICIO
HostWeb podría estudiar diferentes servicios:
creación;
hosting;
mantenimiento;
actualización;
traducción;
integración AInternet;
búsqueda inteligente.
No es necesario que todos pertenezcan a un único paquete.
La modularidad puede facilitar la adopción.
28. HOSTWEB COMO PUERTA DE ENTRADA
Una empresa podría comenzar solicitando:
UNA WEB.
Pero el activo creado podría quedar preparado para:
AINTERNET
SHAZZAM
AGENTES
E-COMMERCE
SERVICIOS IA.
HostWeb puede convertirse así en una puerta de entrada al ecosistema.
29. EL MODELO DE ESCALA
La arquitectura propuesta:
1 OPERADOR
↓
MÚLTIPLES AGENTES
↓
MÚLTIPLES ACTIVOS
↓
1 NODO
Después:
MÚLTIPLES NODOS
↓
HOSTWEB NETWORK
↓
MILLONES DE ACTIVOS.
30. ESCALAMIENTO PROGRESIVO
No debería comenzarse intentando producir 12 millones de páginas.
ETAPA 1
100 páginas.
ETAPA 2
1.000.
ETAPA 3
10.000.
ETAPA 4
100.000.
ETAPA 5
1.000.000.
ETAPA 6
escalamiento hacia el objetivo prospectivo de 12 millones.
Cada etapa debería demostrar que calidad, costos y mantenimiento permanecen controlables.
31. EXPERIMENTO FUNDACIONAL
Seleccionar un mismo proyecto web y producirlo mediante:
A — PRODUCCIÓN MANUAL
B — PLANTILLA + OPERADOR
C — PLANTILLA + OPERADOR + IA
D — HOSTWEB ORCHESTRATED WORKFLOW™
Manteniendo requisitos equivalentes.
Medir:
tiempo;
costo;
errores;
calidad;
intervenciones humanas;
retrabajo.
32. SEGUNDO EXPERIMENTO: ESCALA
Repetir:
10
100
1.000
10.000
unidades digitales.
Medir cómo evoluciona:
COSTO POR UNIDAD
y comprobar si aparecen economías de escala reales.
33. TERCER EXPERIMENTO: OPERADOR HUMANO–IA
Comparar operadores con:
FORMACIÓN TRADICIONAL
frente a:
FORMACIÓN GENACADEMY + AGENTES HOSTWEB.
Medir:
productividad;
calidad;
aprendizaje;
autonomía;
errores.
Esto permitiría probar simultáneamente una hipótesis educativa y productiva.
34. MVP
El primer MVP podría contener:
3–5 PLANTILLAS BASE
5 TIPOS DE SITIOS
10 OPERADORES
5–10 AGENTES ESPECIALIZADOS
100–1.000 ACTIVOS DIGITALES
PRODUCTION ORCHESTRATOR
CONTENT QUALITY GATE
CONTENT LIFECYCLE ENGINE
DASHBOARD PRODUCTIVO
La finalidad sería validar el sistema, no demostrar todavía producción masiva.
35. MÉTRICAS MAESTRAS
TIME PER DIGITAL ASSET™
Tiempo por unidad.
COST PER DIGITAL ASSET™
Costo.
HUMAN INTERVENTION RATE™
Intervención humana.
FIRST-PASS QUALITY RATE™
Activos aprobados sin retrabajo.
REWORK RATE
Retrabajo.
DIGITAL COMPONENT REUSE RATE™
Reutilización.
PRODUCTIVITY MULTIPLIER™
Incremento de productividad.
UPDATE COST
Costo de mantenimiento.
OPERATOR THROUGHPUT™
Producción por operador.
36. RIESGO: PRODUCCIÓN MASIVA DE BAJA CALIDAD
El principal riesgo del sistema es obvio:
LA MISMA TECNOLOGÍA QUE PERMITE PRODUCIR MILLONES DE PÁGINAS PUEDE PRODUCIR MILLONES DE PÁGINAS IRRELEVANTES.
Por eso:
AUTOMATION WITHOUT CURATION = INFORMATIONAL NOISE
HostWeb debe permanecer estructuralmente conectado con los controles de AInternet.
37. RIESGO: HOMOGENEIZACIÓN
La automatización puede generar:
textos repetitivos;
diseños repetitivos;
estructuras previsibles;
pérdida de identidad.
La solución arquitectónica debe separar:
ESTANDARIZACIÓN TÉCNICA
de:
UNIFORMIDAD CREATIVA.
38. RIESGO: DEPENDENCIA TECNOLÓGICA
Si HostWeb depende completamente de:
un proveedor;
una plantilla;
un modelo IA;
un CMS,
la infraestructura se vuelve vulnerable.
Por ello conviene diseñar:
PROVIDER ABSTRACTION™
para permitir reemplazo progresivo de componentes.
Esto coincide con la lógica superior de Harmonix: los modelos, agentes, herramientas y proveedores pueden cambiar mientras la arquitectura mantiene continuidad. Markdown pegado
39. PROPIEDAD Y LICENCIAS
El uso de plantillas y componentes de terceros deberá respetar las condiciones de licencia correspondientes.
Por tanto, la escalabilidad de HostWeb no depende sólo de capacidad técnica.
También de:
DERECHOS DE USO + LICENCIAS + AUTOMATIZACIÓN PERMITIDA + MODELO DE DISTRIBUCIÓN.
Esta dimensión deberá validarse antes del escalamiento comercial.
40. DE EMPLEO DIGITAL A MICROEMPRENDIMIENTO
BoysDesign y GirlsDesign pueden concebirse no sólo como puestos de trabajo.
También como:
MICROUNIDADES PRODUCTIVAS HUMANO–IA.
Un operador formado podría:
producir;
mantener;
gestionar clientes;
administrar activos;
utilizar agentes.
Esto transforma la capacitación en potencial capacidad empresarial.
41. MODELO DE RED
La arquitectura podría evolucionar hacia:
SPACEARCH / HOSTWEB CORE
↓
GENACADEMY
↓
OPERADORES CERTIFICADOS
↓
NODOS PRODUCTIVOS
↓
EMPRESAS / ORGANIZACIONES
↓
ACTIVOS DIGITALES
↓
AINTERNET 7.0.
Así la infraestructura central no necesita producir directamente cada página.
Coordina una red capaz de producirlas.
42. EFECTO DE APRENDIZAJE
Cada proyecto completado puede generar conocimiento sobre:
qué plantilla funciona;
qué estructura falla;
qué tareas consumen tiempo;
qué errores se repiten;
qué automatizaciones funcionan.
El sistema puede convertir experiencia operacional en procedimientos reutilizables.
43. PRODUCTION KNOWLEDGE GRAPH™
Una evolución futura podría ser:
PRODUCTION KNOWLEDGE GRAPH™
relacionando:
sectores;
plantillas;
componentes;
errores;
agentes;
operadores;
resultados.
Entonces HostWeb no sólo produciría sitios.
APRENDERÍA CÓMO PRODUCIRLOS MEJOR.
Siempre sujeto a validación antes de modificar procesos críticos.
44. INTEGRACIÓN CON HARMONIX
Cuando la cantidad de agentes aumente, aparecerá el mismo problema señalado en la arquitectura general de SpaceArch:
¿QUIÉN GOBIERNA EL CONJUNTO?
La documentación actual identifica como desafío coordinar inteligencias heterogéneas sin perder coherencia, memoria, trazabilidad, seguridad ni control humano significativo. Markdown pegado
Harmonix podría investigar esa capa superior.
45. ESTADO ACTUAL
FASE DE PROYECTO
HostWeb: arquitectura propuesta.
Distributed Production Network: propuesta.
BoysDesign/GirlsDesign: modelo productivo-formativo propuesto.
Production Orchestrator: por desarrollar.
Template Intelligence Layer: concepto.
Content Quality Gate: por desarrollar.
Content Lifecycle Engine: concepto.
Production Knowledge Graph: concepto.
Integración con GenAcademy: propuesta.
Productivity Multiplier: no validado.
Economías de escala: no demostradas.
Producción de millones de páginas: no demostrada.
Costo unitario: pendiente de experimentación.
CONCLUSIÓN
HostWeb Distributed Digital Production System™ intenta resolver el problema productivo central de AInternet 7.0:
¿CÓMO PASAR DE CREAR SITIOS INDIVIDUALES A PRODUCIR Y MANTENER MILLONES DE UNIDADES DIGITALES SIN MULTIPLICAR PROPORCIONALMENTE EL COSTO, EL TIEMPO Y LOS ERRORES?
La respuesta propuesta es:
PLANTILLAS
↓
ESTANDARIZACIÓN
↓
IA
↓
AGENTES
↓
OPERADORES HUMANO–IA
↓
ORQUESTACIÓN
↓
CONTROL DE CALIDAD
↓
PUBLICACIÓN
↓
MANTENIMIENTO
↓
APRENDIZAJE PRODUCTIVO.
La hipótesis económica y tecnológica no es que la IA elimine al diseñador.
Es investigar si:
una persona formada, aumentada mediante agentes y operando dentro de una arquitectura estandarizada, puede administrar una capacidad productiva sustancialmente mayor manteniendo niveles verificables de calidad.
Esto conecta directamente HostWeb con la estrategia general de SpaceArch: formar operadores humano–IA capaces de dirigir capacidades que anteriormente requerían equipos mayores. Markdown pegado
Y permite redefinir la meta de los 12 millones de páginas.
No:
12 MILLONES DE PÁGINAS GENERADAS.
Sino:
12 MILLONES DE ACTIVOS DIGITALES PRODUCIDOS, ESTRUCTURADOS, CONTROLADOS, ACTUALIZABLES E INTEGRABLES.
Ésa es una diferencia esencial.
La ecuación conceptual del Paper 03 queda:
TALENTO × IA × ESTANDARIZACIÓN × ORQUESTACIÓN × CALIDAD = CAPACIDAD PRODUCTIVA DIGITAL
Y el criterio de validación permanece:
NO SUPONER LA ESCALA.
MEDIRLA.
SPF-004 · PAPER CORPORATIVO 04
SHAZZAM SEARCH & AI SWARM RETRIEVAL ARCHITECTURE™
Arquitectura de proyecto para evolucionar desde la búsqueda convencional hacia investigación distribuida mediante agentes especializados capaces de descomponer consultas, recuperar información en paralelo, contrastar resultados, detectar contradicciones y construir respuestas contextualizadas y trazables.
SPACEARCH PROJECT FILE — SPF-004
PAPER CORPORATIVO 04
SHAZZAM SEARCH & AI SWARM RETRIEVAL ARCHITECTURE™
Arquitectura de proyecto para búsqueda cognitiva distribuida, investigación multiagente, contraste de evidencia y recuperación contextualizada del conocimiento
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation™
Subsistema: Shazzam Search Modular
Integración: AInternet 7.0 · AI Swarm · AIQuestion OS · TasksAICloud / AIEarth.Agency · Harmonix
Clasificación: Búsqueda Inteligente / Sistemas Multiagente / Recuperación de Información / IA Distribuida
Estado: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL Y DISEÑO PRELIMINAR
Documento: Paper Corporativo 04
Versión: 1.0
Año: 2026
NOTA DE ESTADO DEL PROYECTO
Shazzam Search & AI Swarm Retrieval Architecture™ se encuentra actualmente en fase de proyecto.
El sistema se plantea como una arquitectura futura de búsqueda e investigación distribuida basada en agentes especializados capaces de cooperar sobre la infraestructura de conocimiento de AInternet 7.0.
No constituye actualmente un motor de búsqueda global desplegado ni existe todavía evidencia experimental suficiente para afirmar que supere a los sistemas convencionales de búsqueda, recuperación aumentada o investigación asistida por inteligencia artificial.
El objetivo del programa consiste precisamente en construir las condiciones experimentales para comprobarlo.
La arquitectura propuesta puede resumirse:
PREGUNTA
↓
INTERPRETACIÓN
↓
DESCOMPOSICIÓN
↓
ASIGNACIÓN DE AGENTES
↓
BÚSQUEDA PARALELA
↓
RECUPERACIÓN
↓
CONTRASTE
↓
CONTRADICCIÓN
↓
SÍNTESIS
↓
TRAZABILIDAD
↓
RESPUESTA
1. DEL BUSCADOR AL SISTEMA DE INVESTIGACIÓN
El buscador tradicional resuelve fundamentalmente un problema:
Dada una consulta, ¿qué documentos pueden resultar relevantes?
Shazzam propone investigar un problema diferente:
Dado un objetivo cognitivo, ¿qué tareas de búsqueda, análisis, contraste y síntesis deben ejecutarse para construir una respuesta suficientemente fundada?
La diferencia es estructural.
En el primer paradigma:
CONSULTA → RESULTADOS
En Shazzam:
PROBLEMA → PLAN DE INVESTIGACIÓN → AGENTES → EVIDENCIA → CONTRASTE → RESPUESTA
2. BÚSQUEDA NO ES COMPRENSIÓN
Encontrar un documento no significa comprenderlo.
Encontrar diez documentos tampoco significa:
relacionarlos;
detectar contradicciones;
identificar versiones;
distinguir evidencia de opinión;
establecer incertidumbre;
construir una síntesis.
Shazzam intenta añadir estas operaciones sobre la recuperación convencional.
3. LA CONSULTA COMO OBJETO COGNITIVO
Una pregunta compleja puede contener múltiples subproblemas.
Por ejemplo:
“¿Es viable esta tecnología?”
puede implicar:
¿existe técnicamente?
¿qué componentes necesita?
¿qué evidencia experimental existe?
¿cuánto cuesta?
¿qué riesgos presenta?
¿qué alternativas existen?
¿qué regulaciones podrían afectarla?
Por ello Shazzam no debería enviar necesariamente la consulta completa a un único agente.
Primero puede:
DESCOMPONERLA.
4. QUESTION DECOMPOSITION ENGINE™
Proponemos:
QUESTION DECOMPOSITION ENGINE™
Su función sería convertir:
PREGUNTA COMPLEJA
en:
SUBPREGUNTAS COORDINADAS.
Conceptualmente:
Q
↓
Q1 — técnica
Q2 — científica
Q3 — económica
Q4 — regulatoria
Q5 — histórica
Q6 — crítica
Cada una puede requerir fuentes y capacidades diferentes.
5. QUESTION GRAPH™
Las subpreguntas no son necesariamente independientes.
Pueden existir relaciones:
Q1
depende de
Q2
Q3
contradice
Q4
Q5
aporta contexto a
Q1.
Por ello puede construirse un:
QUESTION GRAPH™
que represente la estructura lógica de la investigación.
6. QUESTION ROUTER™
Una vez descompuesto el problema, un:
QUESTION ROUTER™
determinaría qué agente o combinación de agentes debería ocuparse de cada componente.
La decisión podría considerar:
dominio;
complejidad;
fuentes requeridas;
herramientas;
costo;
prioridad.
7. AGENTES ESPECIALIZADOS
Shazzam podría trabajar con agentes especializados.
Por ejemplo:
SEARCH AGENT
localiza información.
SCIENTIFIC AGENT
analiza evidencia científica.
TECHNICAL AGENT
examina arquitectura.
BUSINESS AGENT
analiza variables empresariales.
SOURCE AGENT
comprueba procedencia.
CONTRADICTION AGENT
busca incompatibilidades.
SYNTHESIS AGENT
integra resultados.
No significa que éstos deban existir exactamente con esas denominaciones.
Constituyen una arquitectura funcional propuesta.
8. DEL AGENTE AL ENJAMBRE
Una investigación compleja puede requerir múltiples agentes trabajando simultáneamente.
AGENTE A
busca.
AGENTE B
contrasta.
AGENTE C
analiza.
AGENTE D
intenta falsar.
AGENTE E
sintetiza.
La arquitectura SpaceArch ya identifica el problema que aparece cuando cientos o miles de componentes comienzan a interactuar: quién gobierna el conjunto y cómo se preservan coherencia, memoria, trazabilidad, seguridad y control humano significativo. Markdown pegado
Shazzam constituye un dominio concreto para investigar esa cuestión.
9. SWARM SEARCH™
Denominamos:
SWARM SEARCH™
al modelo donde una consulta puede generar dinámicamente un conjunto temporal de agentes especializados.
No sería necesariamente:
UN ENJAMBRE PERMANENTE.
Podría ser:
UN EQUIPO COGNITIVO CREADO PARA UNA MISIÓN.
Se forma.
Investiga.
Contrasta.
Entrega resultados.
Se disuelve o reconfigura.
10. DYNAMIC RESEARCH TEAM™
Esta unidad puede denominarse:
DYNAMIC RESEARCH TEAM™
La composición depende de la pregunta.
Una consulta médica, una búsqueda empresarial y una investigación astronómica no requieren necesariamente los mismos agentes.
Por tanto:
PROBLEMA → COMPETENCIAS NECESARIAS → EQUIPO DINÁMICO.
11. COMPETENCY-BASED ROUTING™
Esto conecta Shazzam con la arquitectura de enjambres de SpaceArch.
La unidad fundamental no debería ser:
UN AGENTE CON UN NOMBRE.
Sino:
UNA COMPETENCIA NECESARIA PARA RESOLVER UNA PARTE DEL PROBLEMA.
El orquestador selecciona capacidades.
Los agentes son implementaciones de esas capacidades.
12. PARALLEL RETRIEVAL™
Una ventaja potencial del enjambre sería ejecutar investigaciones paralelas.
En lugar de:
A → B → C → D
podría existir:
A + B + C + D
seguido de:
INTEGRACIÓN.
Esto podría reducir tiempo de investigación.
Pero introduce otro problema:
MÁS AGENTES = MÁS COORDINACIÓN.
Por tanto, paralelización no equivale automáticamente a eficiencia.
13. COGNITIVE COORDINATION COST™
Proponemos medir:
COGNITIVE COORDINATION COST™
es decir, los recursos consumidos para:
coordinar;
sincronizar;
comparar;
resolver duplicaciones;
procesar contradicciones
entre agentes.
Si coordinar diez agentes cuesta más que el beneficio que aportan, el enjambre no sería eficiente.
14. INFORMACIÓN REDUNDANTE
Varios agentes pueden encontrar la misma evidencia.
Shazzam deberá reconocer:
REDUNDANCIA ≠ CONFIRMACIÓN INDEPENDIENTE.
Diez páginas que copian una misma fuente no constituyen diez evidencias independientes.
Esto requiere analizar procedencia.
15. SOURCE PROVENANCE GRAPH™
AInternet puede proporcionar un:
SOURCE PROVENANCE GRAPH™
que relacione:
afirmación;
documento;
autor;
fuente primaria;
derivaciones;
versiones.
Así Shazzam podría intentar distinguir:
múltiples fuentes independientes
de
múltiples reproducciones de una única fuente.
16. CLAIM EXTRACTION™
Los documentos contienen afirmaciones.
Shazzam podría transformarlas en unidades analizables:
CLAIM → SOURCE → EVIDENCE → CONTEXT.
Esto conecta directamente con AIQuestion OS.
17. CLAIM GRAPH™
Las afirmaciones pueden:
apoyarse;
contradecirse;
complementarse;
depender unas de otras.
Un:
CLAIM GRAPH™
permitiría representar estas relaciones.
18. EVIDENCE GRAPH™
De manera complementaria:
EVIDENCE GRAPH™
podría vincular:
afirmación
→ respaldada por
evidencia
o:
afirmación
→ cuestionada por
evidencia.
La respuesta deja así de ser únicamente texto.
Se convierte en:
CONCLUSIÓN + ESTRUCTURA DE EVIDENCIA.
19. CONTRADICTION ENGINE™
Una función crítica será buscar activamente incompatibilidades.
La arquitectura hiperlógica de SpaceArch ya establece que las conclusiones deberían poder someterse a verificación, contradicción, comparación, trazabilidad, falsación, revisión y autocorrección. Markdown pegado
Shazzam puede aplicar este principio directamente a la búsqueda.
20. LA CONTRADICCIÓN NO ES UN ERROR DEL SISTEMA
Si dos fuentes confiables discrepan, Shazzam no debería forzar automáticamente una respuesta única.
Puede indicar:
FUENTE A SOSTIENE X
FUENTE B SOSTIENE Y
EVIDENCIA DISPONIBLE NO RESUELVE COMPLETAMENTE LA DISCREPANCIA.
Esto es superior a fabricar certeza.
La documentación SpaceArch ya define precisamente que el objetivo no consiste en eliminar contradicciones, sino en detectarlas, procesarlas y conservar incertidumbre cuando no puedan resolverse. Markdown pegado
21. FALSIFICATION AGENT™
Un agente especializado podría recibir una misión deliberadamente adversarial:
“INTENTA DEMOSTRAR QUE ESTA CONCLUSIÓN ES INCORRECTA.”
Buscaría:
supuestos débiles;
datos incompatibles;
evidencia faltante;
fuentes alternativas;
casos excepcionales.
Esto conecta con el concepto SpaceArch de blindaje hipercrítico: una arquitectura que presupone su propia falibilidad y somete resultados importantes a preguntas adversariales. Markdown pegado
22. CONSENSO NO ES VERDAD
Otro principio:
MULTI-AGENT CONSENSUS ≠ TRUTH.
Diez agentes pueden coincidir y estar equivocados si:
usan los mismos datos;
comparten sesgos;
dependen del mismo modelo;
repiten la misma fuente.
Por ello el consenso debe analizar:
DIVERSIDAD DE EVIDENCIA
y no sólo
NÚMERO DE AGENTES.
23. EVIDENCE DIVERSITY SCORE™
Podría desarrollarse experimentalmente:
EVIDENCE DIVERSITY SCORE™
para estimar diversidad entre:
fuentes;
procedencias;
tipos de evidencia;
modelos;
agentes.
No determinaría verdad.
Ayudaría a interpretar la robustez del proceso.
24. CONFIDENCE & UNCERTAINTY
La salida de Shazzam debería poder distinguir:
LO QUE ESTÁ BIEN RESPALDADO
LO QUE ES PROBABLE
LO QUE ES INCIERTO
LO QUE ES HIPOTÉTICO
LO QUE NO PUDO DETERMINARSE.
Esto reduce la presión para generar respuestas categóricas cuando la evidencia no las permite.
25. RESPONSE SYNTHESIS ENGINE™
Después de la investigación, un:
RESPONSE SYNTHESIS ENGINE™
integraría:
pregunta;
hallazgos;
evidencia;
contradicciones;
incertidumbre;
procedencia.
Su función no sería simplemente resumir textos.
Sería reconstruir el razonamiento documental de la investigación.
26. ANSWER PROVENANCE™
Toda respuesta importante debería permitir reconstruir:
QUÉ AGENTE ENCONTRÓ QUÉ
QUÉ FUENTE UTILIZÓ
QUÉ AFIRMACIÓN EXTRAJO
QUÉ CONTRADICCIONES APARECIERON
CÓMO SE PRODUJO LA SÍNTESIS.
Podemos denominar esta propiedad:
ANSWER PROVENANCE™
27. EXPLICABILIDAD OPERATIVA
No se pretende explicar internamente cada operación matemática de un modelo.
La meta práctica es otra:
EXPLICAR EL PROCESO DE INVESTIGACIÓN.
Es decir:
qué se buscó;
dónde;
qué se encontró;
qué se descartó;
qué contradicciones permanecen;
qué fuentes sustentan la conclusión.
28. INTEGRACIÓN CON AINTERNET 7.0
Shazzam puede buscar sobre:
WEB EXTERNA
y
AINTERNET.
Pero AInternet ofrece potencialmente una ventaja:
CONTENIDO PREESTRUCTURADO.
En lugar de interpretar desde cero cada documento, los agentes podrían encontrar:
entidades;
metadatos;
relaciones;
procedencia;
versiones
ya representadas.
29. SEARCH + KNOWLEDGE GRAPH
La arquitectura híbrida sería:
SEARCH INDEX
para localizar documentos
KNOWLEDGE GRAPH
para comprender relaciones
VECTOR RETRIEVAL
para similitud semántica
AGENTS
para investigar
AIQUESTION
para cuestionar
HARMONIX
para gobernar.
30. MEMORIA DE INVESTIGACIÓN
Una investigación compleja no debería comenzar siempre desde cero.
Shazzam podría conservar:
RESEARCH MEMORY™
incluyendo:
consultas anteriores;
fuentes utilizadas;
hallazgos;
contradicciones;
hipótesis;
resultados.
Esto permitiría investigación acumulativa.
31. MEMORIA NO SIGNIFICA VERDAD PERMANENTE
El conocimiento cambia.
Por ello:
MEMORIA
debe incluir
VERSIONES + FECHAS + PROCEDENCIA.
Una conclusión anterior puede necesitar revisión cuando aparece nueva evidencia.
32. CONTINUOUS RESEARCH™
Esto permite una evolución interesante.
Una búsqueda puede dejar de ser:
UN EVENTO.
Puede convertirse en:
UN PROCESO CONTINUO.
Por ejemplo, una investigación podría actualizarse cuando:
aparecen nuevas fuentes;
cambian datos;
se publica evidencia;
surge una contradicción.
33. SHAZZAM MODULAR
El término Modular resulta estratégico.
No todos los usuarios necesitan:
50 AGENTES + FALSACIÓN + GRAFO COMPLETO.
Una consulta simple puede resolverse con una búsqueda sencilla.
Una investigación compleja puede activar capas adicionales.
34. ADAPTIVE SEARCH DEPTH™
Proponemos:
ADAPTIVE SEARCH DEPTH™
NIVEL 1
búsqueda directa.
NIVEL 2
recuperación semántica.
NIVEL 3
múltiples fuentes.
NIVEL 4
multiagente.
NIVEL 5
contradicción.
NIVEL 6
falsación.
NIVEL 7
investigación profunda.
El sistema utilizaría únicamente la profundidad necesaria.
35. COST-AWARE SEARCH™
Cada agente consume:
tiempo;
cómputo;
tokens;
consultas;
infraestructura.
Por ello Shazzam debería optimizar:
CALIDAD DE RESPUESTA / COSTO COGNITIVO.
No siempre la búsqueda más profunda será económicamente racional.
36. SEARCH BUDGET™
Cada consulta podría disponer de:
SEARCH BUDGET™
definiendo límites de:
tiempo;
agentes;
fuentes;
cómputo;
profundidad.
El orquestador decidiría cómo utilizar ese presupuesto.
37. STOPPING CRITERION™
Otro problema fundamental:
¿CUÁNDO DEJA DE BUSCAR EL ENJAMBRE?
Sin criterio de detención, una investigación podría continuar indefinidamente.
El sistema debería detenerse cuando:
se alcanza evidencia suficiente;
nuevas búsquedas producen rendimientos decrecientes;
se consume el presupuesto;
la incertidumbre ya no puede reducirse con los recursos disponibles.
38. INFORMATION GAIN™
Una futura métrica podría evaluar:
INFORMATION GAIN™
es decir:
cuánto conocimiento adicional aporta una nueva búsqueda respecto de lo ya encontrado.
Si nuevos agentes sólo reproducen resultados existentes:
GANANCIA DE INFORMACIÓN ≈ BAJA.
El sistema puede detener la expansión.
39. SHAZZAM + HARMONIX
Cuando múltiples agentes investigan simultáneamente, Harmonix puede convertirse en una capa superior de:
identidad;
memoria;
objetivos;
permisos;
contradicciones;
trazabilidad.
Esto corresponde a la función de metaarquitectura de integración cognitiva definida actualmente para Harmonix. Markdown pegado
40. CONTROL HUMANO
Las investigaciones de bajo riesgo pueden requerir mínima intervención.
Pero determinados dominios o acciones pueden necesitar:
HUMAN REVIEW GATE™
antes de:
publicar;
ejecutar;
modificar sistemas;
tomar decisiones críticas.
La arquitectura general de SpaceArch ya plantea la cogobernanza humano–IA mediante mecanismos humanos de autorización, auditoría, revocación y responsabilidad. Markdown pegado
41. MVP DE SHAZZAM
Un MVP inicial podría contener:
1 QUESTION ROUTER
5–10 AGENTES ESPECIALIZADOS
SEARCH INDEX
SEMANTIC RETRIEVAL
QUESTION GRAPH
CLAIM GRAPH
EVIDENCE GRAPH
CONTRADICTION ENGINE
SYNTHESIS ENGINE
ANSWER PROVENANCE
DASHBOARD
No necesita comenzar con miles de agentes.
42. EXPERIMENTO FUNDACIONAL
Utilizar el mismo conjunto de preguntas y comparar:
A — BUSCADOR CONVENCIONAL
B — MODELO IA + BÚSQUEDA
C — RAG CONVENCIONAL
D — SHAZZAM MULTIAGENTE
Manteniendo, en lo posible, corpus, tiempo y recursos comparables.
43. MÉTRICAS
Medir:
RETRIEVAL PRECISION
precisión.
RETRIEVAL COVERAGE
cobertura.
SOURCE DIVERSITY
diversidad.
CONTRADICTION DETECTION RATE™
contradicciones detectadas.
ANSWER TRACEABILITY™
trazabilidad.
INFORMATION GAIN™
información nueva.
RESEARCH LATENCY
tiempo.
COMPUTATIONAL COST
costo.
HUMAN CORRECTION RATE
correcciones humanas.
ANSWER QUALITY
calidad según protocolo previamente definido.
44. EL EXPERIMENTO MÁS IMPORTANTE
Existe una prueba particularmente importante.
Utilizar:
los mismos modelos,
las mismas fuentes,
el mismo presupuesto computacional,
pero comparar:
UN AGENTE
contra:
VARIOS AGENTES SIN GOBERNANZA
contra:
SHAZZAM + GOBERNANZA.
Esta lógica coincide con el experimento comparativo ya propuesto para la arquitectura Harmonix: modelo individual, sistema multiagente convencional y sistema multiagente gobernado, controlando herramientas, información y presupuesto. Markdown pegado
Si Shazzam obtiene mejoras reproducibles:
LA VENTAJA ESTARÍA EN LA ARQUITECTURA
y no simplemente en utilizar un modelo más potente.
45. RELACIÓN CON LOS MIL AGENTES
El objetivo futuro de enjambres grandes no debe comenzar preguntando:
¿CÓMO ACTIVAMOS MIL AGENTES?
Debe preguntar:
¿EN QUÉ PUNTO UN AGENTE ADICIONAL TODAVÍA APORTA VALOR?
Puede existir:
1 → insuficiente
5 → mejor
20 → óptimo
100 → redundante
1.000 → contraproducente
o una relación completamente diferente.
Debe medirse.
46. SWARM EFFICIENCY CURVE™
Esto puede formalizarse mediante:
SWARM EFFICIENCY CURVE™
que compare:
NÚMERO DE AGENTES
contra:
CALIDAD + TIEMPO + COSTO + COORDINACIÓN.
La arquitectura óptima no necesariamente será la más grande.
Será aquella que produzca:
MAYOR INTELIGENCIA ÚTIL POR UNIDAD DE RECURSO.
47. ESCALAMIENTO
FASE 1
3 agentes.
FASE 2
10 agentes.
FASE 3
30 agentes.
FASE 4
100 agentes.
FASE 5
300 agentes.
FASE 6
1.000 agentes, únicamente si las fases anteriores justifican experimentalmente el escalamiento.
Esto transforma la meta de mil agentes en:
UNA HIPÓTESIS DE ESCALA.
48. SHAZZAM COMO LABORATORIO PARA SUPERGAIA
Existe aquí una conexión estratégica.
Shazzam puede funcionar como uno de los entornos experimentales donde SpaceArch estudie:
coordinación;
especialización;
memoria colectiva;
contradicción;
gobernanza;
aprendizaje distribuido.
Es decir, problemas directamente relacionados con arquitecturas de inteligencia colectiva más amplias.
Pero Shazzam permite investigarlos en un dominio acotado:
BÚSQUEDA E INVESTIGACIÓN.
49. ESTADO ACTUAL
FASE DE PROYECTO
Shazzam Search Modular: arquitectura propuesta.
Question Decomposition Engine: concepto.
Question Router: por desarrollar.
Dynamic Research Teams: arquitectura propuesta.
Swarm Search: hipótesis.
Question Graph: propuesto.
Claim Graph: propuesto.
Evidence Graph: propuesto.
Contradiction Engine: integración conceptual.
Falsification Agent: propuesto.
Answer Provenance: por desarrollar.
Adaptive Search Depth: concepto.
Search Budget: concepto.
Information Gain: métrica a diseñar.
Swarm Efficiency Curve: protocolo experimental propuesto.
Superioridad frente a búsqueda convencional: no demostrada.
Superioridad del enjambre frente a un agente individual: no demostrada.
Escalabilidad hacia cientos o miles de agentes: pendiente de validación.
CONCLUSIÓN
Shazzam Search & AI Swarm Retrieval Architecture™ plantea una transformación conceptual:
DE BUSCAR DOCUMENTOS
↓
A ORGANIZAR INVESTIGACIONES.
Y después:
DE UN AGENTE QUE BUSCA
↓
A UN EQUIPO DINÁMICO DE INTELIGENCIAS QUE INVESTIGA.
La arquitectura completa sería:
QUESTION
↓
DECOMPOSITION
↓
QUESTION GRAPH
↓
COMPETENCY ROUTING
↓
DYNAMIC AGENT TEAM
↓
PARALLEL RETRIEVAL
↓
SOURCE PROVENANCE
↓
CLAIM & EVIDENCE GRAPHS
↓
CONTRADICTION
↓
FALSIFICATION
↓
SYNTHESIS
↓
UNCERTAINTY
↓
ANSWER PROVENANCE
↓
RESEARCH MEMORY.
Esto encaja directamente con una tesis mayor que SpaceArch ya está formulando: la próxima frontera puede no depender exclusivamente de producir modelos mayores, sino de conseguir integrar múltiples inteligencias dentro de arquitecturas persistentes, verificables, interoperables y gobernables. Markdown pegado
Por ello, la ecuación conceptual del Paper 04 es:
BÚSQUEDA × ESPECIALIZACIÓN × PARALELIZACIÓN × CONTRADICCIÓN × TRAZABILIDAD = INTELIGENCIA DE RECUPERACIÓN
Pero el resultado sólo tendrá valor si una prueba comparativa demuestra que:
SHAZZAM PRODUCE MÁS CONOCIMIENTO ÚTIL POR UNIDAD DE TIEMPO Y CÓMPUTO.
Hasta entonces:
ES UNA ARQUITECTURA DE PROYECTO.
Y ésa es precisamente la fortaleza del enfoque: convertir una visión de búsqueda en enjambre en una hipótesis tecnológica medible y falsable.
SPF-004 · PAPER CORPORATIVO 05
AI-NATIVE ADDRESSING, IDENTITY & INTEROPERABILITY LAYER™
Arquitectura de proyecto para desarrollar identificadores, direcciones, espacios digitales y protocolos de descubrimiento que permitan localizar e interconectar personas, empresas, contenidos, datasets, servicios y agentes dentro de AInternet 7.0, sin confundir esta futura capa con el sistema público de dominios y direccionamiento de Internet.
SPACEARCH PROJECT FILE — SPF-004
PAPER CORPORATIVO 05
AI-NATIVE ADDRESSING, IDENTITY & INTEROPERABILITY LAYER™
Arquitectura de proyecto para identificación, direccionamiento, descubrimiento e interoperabilidad entre humanos, organizaciones, contenidos, servicios y agentes de inteligencia artificial
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation™
Subsistema: AInternet Native Identity & Addressing Layer
Integración: HostWeb · Shazzam Search Modular · AI Swarm · TasksAICloud / AIEarth.Agency · Harmonix
Clasificación: Identidad Digital / Direccionamiento / Interoperabilidad / Infraestructura AI-Native
Estado: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL Y DISEÑO PRELIMINAR
Documento: Paper Corporativo 05
Versión: 1.0
Año: 2026
NOTA DE ESTADO DEL PROYECTO
AI-Native Addressing, Identity & Interoperability Layer™ se encuentra en fase de proyecto.
AInternet 7.0 plantea como objetivo desarrollar identificadores, direcciones y espacios digitales internos que puedan facilitar el acceso y la interacción entre diferentes componentes de su futura infraestructura.
En esta etapa resulta fundamental establecer una distinción:
AINTERNET NATIVE ADDRESS ≠ DOMINIO DNS PÚBLICO
Los identificadores propuestos no deben presentarse como sustitutos ya existentes de los dominios tradicionales ni como una nueva autoridad global de nombres.
La hipótesis consiste en investigar una capa propia de identidad, descubrimiento y direccionamiento lógico, interoperable con la infraestructura existente cuando resulte necesario.
1. DEL DOCUMENTO A LA ENTIDAD DIGITAL
Internet permite localizar recursos mediante direcciones.
Pero AInternet 7.0 plantea un problema adicional.
Una futura red humano–IA necesitaría identificar no solamente:
PÁGINAS
sino también:
personas;
organizaciones;
agentes;
datasets;
servicios;
proyectos;
productos;
conceptos;
modelos;
herramientas.
Por ello la unidad direccionable puede evolucionar desde:
WEB PAGE
hacia:
DIGITAL ENTITY™
2. EL PROBLEMA DE IDENTIDAD
Un mismo objeto puede aparecer en numerosos lugares.
Por ejemplo, una empresa puede tener:
sitio web;
catálogo;
documentación;
tienda;
perfil;
API;
agentes.
Para una persona, muchas de estas relaciones pueden resultar evidentes.
Para una máquina:
DEBEN REPRESENTARSE.
3. AI-NATIVE IDENTIFIER™
AInternet podría estudiar un:
AI-NATIVE IDENTIFIER™
destinado a proporcionar identidad lógica persistente a una entidad dentro de su infraestructura.
Conceptualmente:
IDENTIDAD
no necesariamente equivale a
UBICACIÓN.
Una entidad puede conservar su identificador aunque cambie:
servidor;
proveedor;
URL;
infraestructura.
4. IDENTIDAD Y DIRECCIÓN NO SON LO MISMO
Esta separación es estructural.
IDENTIDAD
responde:
¿QUÉ ES?
DIRECCIÓN
responde:
¿DÓNDE PUEDO ENCONTRARLO?
SERVICIO
responde:
¿QUÉ PUEDO HACER CON ÉL?
AInternet debería evitar mezclar estas tres dimensiones.
5. PERSISTENT DIGITAL IDENTITY™
Podría desarrollarse una:
PERSISTENT DIGITAL IDENTITY™
capaz de mantener continuidad cuando cambian las localizaciones técnicas.
Esto resulta especialmente importante para agentes.
Un agente podría cambiar de:
modelo;
servidor;
versión;
proveedor
sin que necesariamente cambie su identidad funcional dentro del ecosistema.
Esta lógica coincide con la arquitectura superior planteada para Harmonix, donde modelos, proveedores, agentes y herramientas pueden cambiar mientras el sistema intenta conservar continuidad, identidad, memoria, objetivos y contexto. Markdown pegado
6. AINTERNET NATIVE ADDRESS™
Una dirección nativa de AInternet podría actuar como:
ALIAS HUMANO
asociado a:
IDENTIFICADOR PERSISTENTE
que posteriormente resuelva hacia:
RECURSOS / SERVICIOS / AGENTES.
Conceptualmente:
NOMBRE
↓
IDENTIDAD
↓
RESOLUCIÓN
↓
RECURSO.
7. NO REINVENTAR EL DNS
Una decisión estratégica importante es evitar reconstruir innecesariamente funciones que Internet ya resuelve correctamente.
AInternet puede coexistir con:
DNS;
HTTP/HTTPS;
URLs;
APIs;
Web convencional.
La arquitectura nativa puede operar como:
CAPA SUPERIOR DE IDENTIDAD Y SIGNIFICADO.
No necesita comenzar reemplazando protocolos fundamentales.
8. AINTERNET RESOLUTION LAYER™
Proponemos conceptualmente:
AINTERNET RESOLUTION LAYER™
Su función sería resolver:
IDENTIFICADOR AINTERNET
↓
ENTIDAD
↓
LOCALIZACIONES
↓
SERVICIOS DISPONIBLES.
Una entidad podría tener múltiples endpoints simultáneamente.
9. UNA IDENTIDAD, MÚLTIPLES LOCALIZACIONES
Ejemplo conceptual:
EMPRESA X
podría resolver hacia:
sitio institucional;
catálogo;
tienda;
API;
agente comercial;
documentación;
soporte.
Así, la identidad deja de representar exclusivamente:
UNA PÁGINA
y puede representar:
UN ECOSISTEMA DIGITAL.
10. MACHINE DISCOVERY™
Un agente necesita algo más que una dirección.
Necesita descubrir:
qué existe;
qué función cumple;
cómo acceder;
qué formato utiliza;
qué permisos requiere;
qué capacidades ofrece.
AInternet puede incorporar:
MACHINE DISCOVERY™
como función nativa.
11. CAPABILITY DESCRIPTION™
Cada servicio o agente podría declarar:
IDENTIDAD
TIPO
CAPACIDADES
INTERFACES
PERMISOS
VERSIONES
mediante una descripción estructurada.
Así otro agente podría determinar:
¿Este recurso puede resolver mi tarea?
antes de utilizarlo.
12. DEL DIRECTORIO AL GRAFO
Un directorio convencional registra:
NOMBRE → DIRECCIÓN.
AInternet podría evolucionar hacia:
ENTIDAD → IDENTIDAD → RELACIONES → CAPACIDADES → SERVICIOS → LOCALIZACIONES.
Esto transforma el direccionamiento en una arquitectura semántica.
13. AINTERNET ENTITY GRAPH™
Puede proponerse:
AINTERNET ENTITY GRAPH™
que represente:
humanos;
empresas;
agentes;
documentos;
servicios;
proyectos;
productos
y las relaciones entre ellos.
Esto complementaría el Knowledge Graph desarrollado conceptualmente en el Paper 01.
14. IDENTIDAD DE AGENTES
Los agentes introducen un problema nuevo.
Un usuario debería poder saber:
¿CON QUÉ AGENTE ESTOY INTERACTUANDO?
¿QUIÉN LO OPERA?
¿QUÉ PUEDE HACER?
¿QUÉ NO PUEDE HACER?
¿QUÉ PERMISOS POSEE?
¿QUÉ VERSIÓN ESTÁ ACTIVA?
La identidad del agente se convierte así en un componente de gobernanza.
15. AGENT IDENTITY RECORD™
Podría estudiarse un:
AGENT IDENTITY RECORD™
con campos conceptuales como:
identificador;
operador;
función;
competencias;
permisos;
modelo utilizado;
versión;
estado.
No todos estos campos tendrían necesariamente que ser públicos.
16. IDENTIDAD NO IMPLICA CONFIANZA
Un principio fundamental:
IDENTIFICAR ≠ CONFIAR.
Saber qué agente participa no demuestra que:
sea competente;
sea seguro;
diga la verdad;
tenga autorización.
Por ello identidad y confianza deben permanecer separadas.
17. TRUST LAYER™
Una futura:
TRUST LAYER™
podría incorporar información sobre:
procedencia;
autorizaciones;
historial;
certificaciones cuando correspondan;
estado operativo.
Pero tampoco debería producir una falsa garantía absoluta.
18. PERMISSION ARCHITECTURE™
Los agentes no deberían poseer acceso universal.
Cada identidad puede asociarse con:
PERMISOS MÍNIMOS NECESARIOS.
Por ejemplo:
agente de búsqueda
puede leer.
agente editorial
puede proponer modificaciones.
agente administrador
puede ejecutar determinadas acciones.
La arquitectura superior de SpaceArch ya identifica permisos, políticas y autoridad de ejecución como problemas fundamentales de gobernanza multiagente. Markdown pegado
19. CAPABILITY ≠ AUTHORITY
Otra distinción crítica:
UN AGENTE PUEDE SER CAPAZ DE HACER ALGO
sin estar:
AUTORIZADO PARA HACERLO.
Por tanto:
CAPABILITY
describe capacidad.
PERMISSION
describe autorización.
Separarlas reduce riesgos.
20. AGENT-TO-AGENT DISCOVERY™
AInternet 7.0 podría permitir que agentes descubran otros agentes según competencias.
Conceptualmente:
AGENTE A
necesita traducción.
↓
DISCOVERY LAYER
localiza agentes capaces.
↓
PERMISSION CHECK
determina cuáles son utilizables.
↓
AGENTE B
ejecuta.
Esto permite formar equipos dinámicos.
21. COMPETENCY DISCOVERY™
La búsqueda podría realizarse por:
COMPETENCIA
en lugar de:
NOMBRE DEL AGENTE.
Por ejemplo:
“NECESITO ANALIZAR UN DOCUMENTO CIENTÍFICO”
↓
El sistema identifica agentes con competencias relevantes.
Esto conecta directamente con la arquitectura de Shazzam desarrollada en el Paper 04.
22. INTEROPERABILIDAD ENTRE AGENTES
Descubrir agentes no basta.
Necesitan poder intercambiar:
solicitudes;
resultados;
metadatos;
estados;
errores.
Por ello AInternet requiere estudiar formatos y protocolos interoperables.
23. AI-NATIVE INTEROPERABILITY LAYER™
Proponemos:
AI-NATIVE INTEROPERABILITY LAYER™
como una capa destinada a normalizar interacciones entre sistemas heterogéneos.
La meta no sería obligar a todos los agentes a utilizar el mismo modelo.
Precisamente lo contrario:
PERMITIR COOPERACIÓN ENTRE COMPONENTES DIFERENTES.
24. MODEL-AGNOSTIC ARCHITECTURE™
AInternet debería intentar permanecer:
MODEL-AGNOSTIC.
Un agente podría funcionar sobre:
modelo A;
modelo B;
modelo C;
modelo local;
sistema futuro.
La infraestructura superior no debería depender completamente de uno de ellos.
Esta idea coincide con la hipótesis de Harmonix: modelos y proveedores pueden cambiar mientras una arquitectura superior conserva continuidad sistémica. Markdown pegado
25. PROVIDER ABSTRACTION™
Puede existir:
PROVIDER ABSTRACTION LAYER™
entre:
AINTERNET
y
PROVEEDORES EXTERNOS.
Así, cambiar una tecnología subyacente no debería exigir reconstruir todo el ecosistema.
26. VERSIONADO
Identidad persistente no significa que un recurso sea inmutable.
Debe poder existir:
AGENTE X v1
AGENTE X v2
AGENTE X v3
manteniendo relación histórica.
Lo mismo para:
documentos;
datasets;
servicios;
modelos.
27. VERSION GRAPH™
Podría desarrollarse:
VERSION GRAPH™
que represente:
DERIVA DE
REEMPLAZA
ACTUALIZA
DEPRECIA
entre versiones.
Esto mejora trazabilidad.
28. PROVENANCE
La identidad también debe conservar procedencia.
Para un contenido:
¿quién lo produjo?
Para un dataset:
¿de dónde procede?
Para un agente:
¿quién lo administra?
Para una modificación:
¿qué sistema la realizó?
La procedencia conecta identidad con auditoría.
29. DIGITAL PROVENANCE CHAIN™
Podría representarse:
ORIGEN
↓
CREACIÓN
↓
TRANSFORMACIÓN
↓
PUBLICACIÓN
↓
ACTUALIZACIÓN
↓
VERSIÓN ACTUAL.
Esto constituye una:
DIGITAL PROVENANCE CHAIN™
30. HOSTWEB COMO EMISOR DE ACTIVOS
HostWeb puede generar activos preparados desde el origen con:
identificador;
metadatos;
estructura;
procedencia;
versión;
relaciones.
Entonces HostWeb no sólo produce páginas.
PRODUCE ENTIDADES AINTERNET-READY™.
31. SHAZZAM COMO CONSUMIDOR DE IDENTIDAD
Shazzam puede utilizar esta capa para determinar:
qué encontró;
qué versión;
quién lo produjo;
con qué otros recursos se relaciona.
Esto puede reducir ambigüedad durante la investigación multiagente.
32. HARMONIX COMO CAPA DE GOBERNANZA
Harmonix puede utilizar identidad persistente para mantener:
memoria;
responsabilidad;
contexto;
permisos;
historial de agentes.
La arquitectura SpaceArch define precisamente Harmonix como una metaarquitectura destinada a coordinar identidad persistente, memoria, objetivos, agentes, modelos, permisos, políticas, contradicciones, incertidumbre, supervisión y trazabilidad. Markdown pegado
33. INTEROPERABILIDAD HUMANO–IA
La interoperabilidad no debe limitarse a máquina–máquina.
Un humano necesita poder:
encontrar agentes;
comprender sus funciones;
autorizar acciones;
revocar permisos;
examinar resultados.
La documentación SpaceArch concibe precisamente la unidad cognitiva como una combinación humano + IA + agentes + memoria + herramientas + metacognición. Markdown pegado
34. IDENTIFICADORES GRATUITOS
La propuesta original contempla identificadores, direcciones o dominios internos gratuitos.
Para mantener precisión:
GRATUITO PARA EL USUARIO ≠ SIN COSTO PARA EL SISTEMA.
Cada identidad genera potencialmente costos de:
registro;
resolución;
almacenamiento;
seguridad;
moderación;
mantenimiento.
El modelo económico deberá determinar quién absorbe esos costos.
35. NAMESPACE AINTERNET™
Una opción conceptual sería crear:
AINTERNET NAMESPACE™
como espacio lógico interno.
Podría permitir nombres legibles asociados a identificadores persistentes.
Pero su sintaxis, gobernanza, resolución y relación con sistemas existentes deberán definirse técnicamente.
36. GOBERNANZA DEL NAMESPACE
Si dos entidades quieren el mismo nombre:
¿quién lo recibe?
Si una identidad suplanta a otra:
¿cómo se resuelve?
Si una empresa desaparece:
¿qué sucede con el identificador?
Si existe abuso:
¿quién interviene?
El direccionamiento introduce inevitablemente:
GOBERNANZA.
37. IDENTITY GOVERNANCE™
Por ello proponemos:
IDENTITY GOVERNANCE™
con procedimientos para:
creación;
verificación;
modificación;
suspensión;
recuperación;
revocación;
resolución de conflictos.
38. IDENTIDAD DESCENTRALIZADA O FEDERADA
AInternet no debería asumir prematuramente que todas las identidades deban depender de una única base central.
Debe investigar alternativas:
CENTRALIZADA
más simple inicialmente.
FEDERADA
múltiples nodos coordinados.
HÍBRIDA
núcleo común + autoridades distribuidas.
La decisión deberá surgir de experimentación, seguridad y gobernanza.
39. FEDERATED IDENTITY NODES™
En una arquitectura futura podrían existir:
FEDERATED IDENTITY NODES™
para diferentes:
regiones;
organizaciones;
ecosistemas;
tipos de entidad.
Todos interoperando mediante reglas comunes.
40. SEGURIDAD DE IDENTIDAD
Una infraestructura de identidad crea un objetivo crítico para atacantes.
Los riesgos incluyen:
suplantación;
robo de credenciales;
secuestro de identificadores;
agentes falsos;
manipulación de resolución.
Por ello la identidad deberá diseñarse con seguridad desde el inicio.
41. ZERO-TRUST IDENTITY™
Puede adoptarse conceptualmente:
ZERO-TRUST IDENTITY™
Una identidad registrada no obtiene automáticamente permisos elevados.
Cada interacción debe considerar:
identidad;
contexto;
permiso;
riesgo;
acción solicitada.
42. PRIVACIDAD
No toda información asociada a una identidad debe ser pública.
La arquitectura debería separar:
PUBLIC IDENTITY DATA
PRIVATE OPERATIONAL DATA
RESTRICTED SECURITY DATA
Esto será especialmente importante para personas y organizaciones.
43. DATA MINIMIZATION
Otro principio:
IDENTIFICAR UNA ENTIDAD NO REQUIERE PUBLICAR TODO SOBRE ELLA.
La infraestructura debería recopilar y exponer únicamente los datos necesarios para cada función.
44. INTEROPERABILIDAD CON LA WEB EXISTENTE
AInternet debe poder resolver hacia:
sitios web;
APIs;
documentos;
servicios externos.
La arquitectura inicial debería ser:
COMPLEMENTARIA
antes que:
SUSTITUTIVA.
Esto reduce la barrera de adopción.
45. INTEROPERABILIDAD CON FUTURAS IA
El diseño también debe evitar quedar cerrado a la tecnología de 2026.
La infraestructura debería intentar que:
NUEVOS MODELOS
NUEVOS AGENTES
NUEVAS INTERFACES
puedan integrarse posteriormente.
Esto exige modularidad.
46. AI-NATIVE SERVICE DIRECTORY™
Podría existir un:
AI-NATIVE SERVICE DIRECTORY™
donde agentes y servicios publiquen capacidades estructuradas.
Por ejemplo:
servicio
→ traducción
idiomas
→ ES / EN / FR / PT
modalidad
→ API / agente
permisos
→ públicos/restringidos
versión
→ vigente.
47. AGENT MARKETPLACE COMO EVOLUCIÓN POSIBLE
Si la arquitectura madura, el directorio podría evolucionar hacia un entorno donde agentes y servicios puedan:
descubrirse;
compararse;
contratarse;
combinarse.
Pero esto constituye una fase prospectiva.
No forma parte de una capacidad actualmente validada.
48. EXPERIMENTO FUNDACIONAL
El primer experimento podría crear:
1.000 ENTIDADES
incluyendo:
páginas;
organizaciones;
agentes;
datasets;
servicios.
Asignarles:
identificadores;
versiones;
capacidades;
relaciones;
localizaciones.
Luego comprobar:
¿Puede un agente descubrir y utilizar correctamente un recurso sin conocer previamente su URL o proveedor?
49. SEGUNDO EXPERIMENTO: PORTABILIDAD
Mover un servicio desde:
PROVEEDOR A
a:
PROVEEDOR B
manteniendo:
LA MISMA IDENTIDAD.
Medir si los agentes pueden seguir localizándolo sin reconfiguración sustancial.
Esto probaría la separación:
IDENTITY ≠ LOCATION.
50. TERCER EXPERIMENTO: MULTIAGENTE
Proporcionar una tarea que requiera:
agente de búsqueda
agente analítico
agente de traducción
agente de síntesis.
Ninguno conoce inicialmente a los demás.
El sistema debe:
DESCUBRIR → VERIFICAR → CONECTAR → EJECUTAR.
51. CUARTO EXPERIMENTO: SEGURIDAD
Introducir:
identidades falsas;
permisos incorrectos;
versiones obsoletas;
endpoints manipulados;
agentes no autorizados.
Medir capacidad para:
DETECTAR
BLOQUEAR
REGISTRAR
RECUPERAR.
52. MVP
Un MVP podría contener:
1.000–10.000 IDENTIDADES
AINTERNET NAMESPACE
RESOLUTION LAYER
ENTITY GRAPH
SERVICE DIRECTORY
AGENT IDENTITY RECORDS
PERMISSION LAYER
VERSION GRAPH
PROVENANCE CHAIN
DISCOVERY API
AUDIT LOG
Todo inicialmente dentro de un entorno controlado.
53. MÉTRICAS
IDENTITY RESOLUTION SUCCESS RATE™
Porcentaje de resoluciones correctas.
DISCOVERY SUCCESS RATE™
Recursos encontrados correctamente.
IDENTITY PERSISTENCE RATE™
Continuidad después de migraciones.
INTEROPERABILITY SUCCESS RATE™
Interacciones completadas entre sistemas heterogéneos.
UNAUTHORIZED ACTION BLOCK RATE™
Acciones no autorizadas detenidas.
DISCOVERY LATENCY
Tiempo de descubrimiento.
IDENTITY COLLISION RATE
Conflictos.
PORTABILITY SUCCESS RATE™
Capacidad de mantener identidad al cambiar infraestructura.
54. ESCALAMIENTO
La progresión debería ser:
1.000 IDENTIDADES
↓
10.000
↓
100.000
↓
1.000.000
↓
ESCALA MULTIMILLONARIA
Midiendo en cada fase:
latencia;
costo;
seguridad;
consistencia;
resolución;
gobernanza.
55. RELACIÓN CON LOS 12 MILLONES DE ACTIVOS
Cuando AInternet alcance eventualmente una escala de millones de activos, la identidad adquiere una importancia fundamental.
Sin una arquitectura de identificación:
12 MILLONES DE PÁGINAS
son principalmente volumen.
Con:
identidad;
relaciones;
procedencia;
versiones;
capacidades;
pueden convertirse en:
UNA RED COMPUTACIONALMENTE NAVEGABLE DE ENTIDADES DIGITALES.
56. ESTADO ACTUAL
FASE DE PROYECTO
AI-Native Identifier: concepto.
Persistent Digital Identity: propuesta.
AInternet Native Address: propuesta.
AInternet Resolution Layer: por desarrollar.
AInternet Namespace: concepto.
Entity Graph: propuesto.
Agent Identity Record: concepto.
Trust Layer: por diseñar.
Permission Architecture: propuesta.
Machine Discovery: por desarrollar.
Service Directory: concepto.
Federated Identity Nodes: prospectivo.
Interoperabilidad multiagente: por validar.
Identificadores gratuitos: hipótesis económica y operativa.
Sustitución del DNS: no planteada como capacidad actual.
Escala multimillonaria: no validada.
CONCLUSIÓN
AI-Native Addressing, Identity & Interoperability Layer™ intenta resolver un problema que se vuelve crítico cuando Internet deja de conectar únicamente páginas y comienza a conectar:
HUMANOS
ORGANIZACIONES
CONOCIMIENTO
SERVICIOS
AGENTES IA.
La arquitectura propuesta evoluciona:
URL
↓
IDENTIDAD PERSISTENTE
↓
ENTIDAD
↓
CAPACIDADES
↓
PERMISOS
↓
LOCALIZACIONES
↓
RELACIONES
↓
DESCUBRIMIENTO
↓
INTEROPERABILIDAD.
Su principio fundamental es:
IDENTITY ≠ LOCATION
CAPABILITY ≠ AUTHORITY
DISCOVERY ≠ TRUST
Estas tres separaciones permiten construir una arquitectura considerablemente más rigurosa.
Además, el proyecto encaja con la estrategia superior de SpaceArch: integrar inteligencias heterogéneas preservando identidad, memoria, objetivos, permisos, políticas y trazabilidad aunque cambien los modelos y proveedores subyacentes. Markdown pegado
La ecuación conceptual del Paper 05 queda:
IDENTIDAD + DESCUBRIMIENTO + CAPACIDADES + PERMISOS + INTEROPERABILIDAD = CONECTIVIDAD AI-NATIVE
Y nuevamente el criterio de desarrollo debe ser:
NO CREAR PRIMERO UNA NUEVA AUTORIDAD GLOBAL DE DIRECCIONES.
CONSTRUIR PRIMERO UN PROTOTIPO QUE DEMUESTRE QUE UNA CAPA DE IDENTIDAD AI-NATIVE APORTA VALOR REAL.
SPF-004 · PAPER CORPORATIVO 06
GLOBAL ACCESS, ECONOMIC & SCALING MODEL™
Arquitectura económica de proyecto para evaluar la viabilidad de una membresía global de USD 1–2 mensuales, producción y mantenimiento de hasta 12 millones de activos digitales, economías de escala, infraestructura computacional, adquisición de usuarios, reinversión y expansión internacional de AInternet 7.0.
SPACEARCH PROJECT FILE — SPF-004
PAPER CORPORATIVO 06
GLOBAL ACCESS, ECONOMIC & SCALING MODEL™
Arquitectura económica de proyecto para acceso global de bajo costo, escalamiento progresivo, sostenibilidad operativa y expansión internacional de AInternet 7.0
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation™
Integración: HostWeb · Shazzam Search Modular · AI Swarm · GenAcademy · TasksAICloud / AIEarth.Agency
Clasificación: Economía Digital / Infraestructura AI-Native / Escalamiento / Acceso Global
Estado: FASE DE PROYECTO — MODELO ECONÓMICO Y ARQUITECTURA DE ESCALAMIENTO PRELIMINARES
Documento: Paper Corporativo 06
Versión: 1.0
Año: 2026
NOTA DE ESTADO DEL PROYECTO
AInternet 7.0 plantea como hipótesis económica una membresía global aproximada de:
USD 1–2 MENSUALES
combinada con una infraestructura progresivamente escalable de contenidos estructurados, búsqueda inteligente, agentes de IA y servicios digitales.
Esta cifra constituye actualmente:
UNA HIPÓTESIS DE PRECIO, NO UNA ECONOMÍA UNITARIA VALIDADA.
Del mismo modo, el objetivo de organizar hasta 12 millones de páginas o activos digitales debe entenderse como una meta prospectiva de escala.
La viabilidad económica deberá demostrarse mediante:
prototipos;
costos reales;
consumo computacional;
retención;
utilización;
ingreso por usuario;
margen de contribución;
economías de escala.
1. LA HIPÓTESIS ECONÓMICA
AInternet 7.0 parte de una tesis:
una infraestructura digital global puede alcanzar accesibilidad masiva si el costo unitario de servicio disminuye suficientemente con la escala.
Por tanto, el problema económico no es simplemente:
¿PODEMOS COBRAR USD 1?
La pregunta correcta es:
¿PODEMOS PRESTAR UN SERVICIO DE VALOR POR USD 1–2 MENSUALES Y CONSERVAR UNA ECONOMÍA OPERATIVA SOSTENIBLE?
2. ACCESIBILIDAD COMO DISEÑO
El precio reducido no debería considerarse únicamente una estrategia comercial.
Forma parte del diseño conceptual.
AInternet busca reducir barreras de acceso mediante:
BAJO PRECIO
AUTOMATIZACIÓN
PRODUCCIÓN DISTRIBUIDA
ECONOMÍAS DE ESCALA.
Pero estas relaciones deberán comprobarse.
3. LA ECUACIÓN FUNDAMENTAL
El sistema económico puede representarse:
USUARIOS
↓
MEMBRESÍAS
↓
INGRESOS
↓
COSTOS OPERATIVOS
↓
MARGEN DE CONTRIBUCIÓN
↓
REINVERSIÓN
↓
MAYOR INFRAESTRUCTURA
↓
MAYOR CAPACIDAD
↓
NUEVOS USUARIOS.
Éste constituye el ciclo económico hipotético de AInternet.
4. PRECIO NO ES MODELO DE NEGOCIO
Definir:
USD 1–2
no determina todavía la viabilidad.
Debe conocerse:
COST TO SERVE™
es decir, cuánto cuesta realmente atender a cada usuario.
Este costo puede incluir:
infraestructura;
almacenamiento;
búsqueda;
inferencia de IA;
transferencia de datos;
seguridad;
soporte;
administración;
pagos;
actualización de contenidos.
5. ECONOMÍA UNITARIA
La primera unidad de análisis debería ser:
UN USUARIO / UN MES.
Para cada usuario deben estimarse:
ingreso mensual
menos
costos variables
igual a
MARGEN DE CONTRIBUCIÓN UNITARIO.
Sin esa información, millones de usuarios pueden representar tanto una oportunidad como una multiplicación de pérdidas.
6. MEMBERSHIP ECONOMICS ENGINE™
Proponemos:
MEMBERSHIP ECONOMICS ENGINE™
para modelar escenarios de:
precio;
usuarios;
consumo;
retención;
costo de IA;
almacenamiento;
soporte;
margen.
El objetivo no sería encontrar una cifra comercial atractiva, sino identificar:
QUÉ COMBINACIONES SON SOSTENIBLES.
7. TRES ESCENARIOS DE PRECIO
Inicialmente pueden simularse:
ESCENARIO A — USD 1
ESCENARIO B — USD 1,50
ESCENARIO C — USD 2
No para decidir arbitrariamente el mejor.
Sino para estudiar sensibilidad económica.
8. USO DESIGUAL
No todos los miembros consumirán los mismos recursos.
Un usuario puede realizar pocas consultas.
Otro puede activar búsquedas multiagente complejas.
Por ello:
MISMO PRECIO ≠ MISMO COSTO.
Este punto resulta crítico cuando la infraestructura incorpora IA.
9. COMPUTE INTENSITY™
Podría medirse:
COMPUTE INTENSITY™
por usuario, sesión y consulta.
Esto permitiría conocer qué servicios son económicamente compatibles con una membresía de bajo costo.
10. BÚSQUEDA ADAPTATIVA Y ECONOMÍA
Aquí el Paper 04 adquiere importancia económica.
Shazzam no necesita utilizar un enjambre complejo para cada consulta.
consulta sencilla
→ búsqueda sencilla.
consulta compleja
→ mayor profundidad.
investigación avanzada
→ enjambre.
Así:
COMPLEJIDAD COMPUTACIONAL ∝ COMPLEJIDAD NECESARIA DE LA TAREA.
Este principio puede ser esencial para mantener costos controlados.
11. SEARCH BUDGET COMO CONTROL ECONÓMICO
El Search Budget™ propuesto para Shazzam puede convertirse también en instrumento financiero.
Cada nivel de servicio podría establecer límites sobre:
agentes;
consultas;
profundidad;
tiempo;
cómputo.
De esta manera:
ARQUITECTURA COGNITIVA Y ARQUITECTURA ECONÓMICA SE CONECTAN.
12. MEMBRESÍA BASE
Una posible estructura conceptual sería:
AINTERNET BASIC MEMBERSHIP™
con acceso a:
navegación;
búsqueda;
contenidos;
identidad AInternet;
servicios básicos.
El precio objetivo de USD 1–2 podría evaluarse principalmente sobre esta capa.
13. SERVICIOS DE MAYOR INTENSIDAD
Funciones intensivas como:
investigación multiagente;
procesamiento masivo;
servicios empresariales;
automatización avanzada
podrían requerir modelos económicos adicionales.
Esto evita obligar a que una membresía mínima subsidie ilimitadamente operaciones costosas.
14. MODELO MODULAR DE INGRESOS
Por tanto, AInternet puede investigar:
MEMBERSHIP
SERVICIOS PREMIUM
SERVICIOS EMPRESARIALES
HOSTWEB
SERVICIOS AI-NATIVE.
No todos tienen que estar incluidos en USD 1–2.
15. PRINCIPIO DE ACCESO
La membresía económica puede seguir siendo la puerta de entrada.
BAJO COSTO DE ACCESO
↓
GRAN BASE POTENCIAL
↓
SERVICIOS MODULARES
↓
DIVERSIFICACIÓN DE INGRESOS.
Es una hipótesis comercial a validar.
16. LOS 12 MILLONES DE ACTIVOS
El objetivo de hasta 12 millones de páginas introduce otra dimensión económica.
Cada activo posee:
COSTO DE CREACIÓN
COSTO DE ALMACENAMIENTO
COSTO DE INDEXACIÓN
COSTO DE ACTUALIZACIÓN
COSTO DE CONTROL.
Por tanto:
PUBLICAR NO ES EL FINAL DEL COSTO.
17. LIFECYCLE COST™
Debe calcularse:
DIGITAL ASSET LIFECYCLE COST™
desde:
creación
hasta:
archivo o sustitución.
Esto permite conocer el verdadero costo de mantener una infraestructura multimillonaria.
18. COST PER ACTIVE ASSET™
Otra métrica:
COST PER ACTIVE ASSET™
El objetivo no debería ser solamente reducir el costo de producir una página.
También reducir el costo de mantenerla útil.
19. ACTIVOS INACTIVOS
Un activo que:
nadie visita;
ningún agente consulta;
no aporta relaciones;
no genera utilidad
puede representar un costo sin valor proporcional.
Por ello AInternet deberá medir utilización.
20. KNOWLEDGE UTILIZATION RATE™
Proponemos:
KNOWLEDGE UTILIZATION RATE™
para estimar qué proporción del corpus participa realmente en:
consultas;
investigaciones;
navegación;
relaciones;
servicios.
Esto permite distinguir:
ESCALA NOMINAL
de
ESCALA ÚTIL.
21. NO CONFUNDIR VOLUMEN CON VALOR
Este principio debe quedar incorporado al SPF-004:
12 MILLONES DE PÁGINAS ≠ 12 MILLONES DE ACTIVOS VALIOSOS.
El valor depende de:
calidad;
estructura;
vigencia;
conectividad;
utilización.
22. HOSTWEB Y REDUCCIÓN DE COSTOS
HostWeb tiene una función económica central.
Su hipótesis consiste en disminuir el costo unitario mediante:
plantillas;
automatización;
agentes;
reutilización;
operadores humano–IA.
Pero esta reducción debe medirse experimentalmente.
23. ECONOMÍAS DE ESCALA
El modelo supone que determinados costos no crecerán linealmente con cada nuevo usuario o activo.
Por ejemplo:
una infraestructura central
puede servir a:
muchos usuarios.
Sin embargo, otros costos sí aumentan con el uso:
inferencia;
transferencia;
soporte;
almacenamiento.
Por tanto, las economías de escala deben calcularse por componente.
24. SCALE ECONOMICS CURVE™
Podría desarrollarse:
SCALE ECONOMICS CURVE™
comparando:
usuarios
activos
consultas
contra:
costo unitario.
El objetivo sería detectar dónde aparecen economías y dónde aparecen nuevos cuellos de botella.
25. CAPITAL INICIAL
El modelo de bajo precio no elimina la necesidad de capital.
Antes de generar escala deberán financiarse:
arquitectura;
software;
prototipos;
infraestructura;
seguridad;
pruebas;
equipo;
operación inicial.
Por tanto:
LOW-COST MEMBERSHIP ≠ ZERO-CAPITAL DEVELOPMENT.
26. TRES TIPOS DE CAPITAL
Conviene distinguir:
DEVELOPMENT CAPITAL™
para construir.
OPERATING CAPITAL™
para operar.
SCALING CAPITAL™
para expandir.
Esta separación permite evaluar mejor necesidades financieras.
27. FINANCIAR PRIMERO LA EVIDENCIA
La secuencia más eficiente no debería ser:
FINANCIAR 12 MILLONES DE PÁGINAS DESDE EL DÍA UNO.
Sino:
CAPITAL
↓
MVP
↓
EVIDENCIA
↓
PILOTO
↓
ECONOMÍA UNITARIA
↓
ESCALAMIENTO.
Así cada ronda de desarrollo financia una reducción concreta de incertidumbre.
28. MILESTONE-BASED CAPITAL™
Puede estructurarse:
MILESTONE-BASED CAPITAL™
donde cada etapa de inversión esté asociada a una demostración.
Por ejemplo:
MILESTONE 1
prototipo.
MILESTONE 2
10.000 activos.
MILESTONE 3
Shazzam funcional.
MILESTONE 4
primeros usuarios.
MILESTONE 5
economía unitaria.
MILESTONE 6
expansión internacional.
29. EL CICLO DE REINVERSIÓN
Si la plataforma alcanza margen positivo, puede estudiarse:
REVENUE
↓
OPERATING COST
↓
CONTRIBUTION MARGIN
↓
REINVESTMENT
↓
CONTENT + INFRASTRUCTURE + USERS
↓
NEW REVENUE.
Esto constituiría:
AINTERNET REINVESTMENT LOOP™
Pero debe tratarse como hipótesis hasta existir operación real.
30. SELF-FUNDED SCALING™
Una meta futura podría ser que una proporción creciente del crecimiento sea financiada por la propia actividad.
Denominamos:
SELF-FUNDED SCALING™
a esa condición.
No significa:
“AInternet no necesita inversión”.
Significa:
la dependencia relativa del capital externo podría disminuir si la operación genera excedentes suficientes para financiar parte del crecimiento.
31. BREAK-EVEN
Una métrica fundamental será:
BREAK-EVEN MEMBERSHIP™
cantidad aproximada de membresías necesarias para cubrir una estructura determinada de costos.
No existe todavía una cifra validada.
Deberá calcularse a partir del MVP.
32. MEMBER CONTRIBUTION MARGIN™
Para cada miembro:
MEMBERSHIP REVENUE
−
VARIABLE SERVICE COST
=
MEMBER CONTRIBUTION MARGIN™
Esta métrica permitirá saber si aumentar usuarios mejora o deteriora la economía.
33. RETENCIÓN
Una membresía mensual sólo adquiere valor si existe permanencia.
Por ello deberá medirse:
MEMBER RETENTION™
y su contraparte:
CHURN.
Un precio bajo puede facilitar adquisición.
No garantiza retención.
34. UTILIDAD PERCIBIDA
La razón para permanecer debe ser:
VALOR RECURRENTE.
Podría provenir de:
búsqueda;
conocimiento;
servicios;
identidad;
herramientas;
IA;
ecosistema.
La membresía debe financiar una relación continua, no una visita ocasional.
35. COSTO DE ADQUISICIÓN
Incluso una membresía de USD 1 puede resultar inviable si captar un miembro cuesta demasiado.
Por ello debe medirse:
MEMBER ACQUISITION COST™
y compararse con el valor económico generado durante la permanencia.
36. ORGANIC NETWORK GROWTH™
AInternet debería investigar mecanismos de crecimiento orgánico.
Por ejemplo:
usuarios que crean activos;
empresas que incorporan contenidos;
HostWeb que incorpora organizaciones;
GenAcademy que forma operadores;
operadores que incorporan nuevos usuarios.
Esto podría disminuir costos de adquisición.
Debe comprobarse.
37. GENACADEMY COMO INFRAESTRUCTURA ECONÓMICA
GenAcademy puede reducir una barrera crítica:
ESCASEZ DE OPERADORES.
La documentación SpaceArch la define como infraestructura de formación, mientras que el ecosistema mayor conecta educación, talento humano–IA, investigación, prototipos, empresas y mercados. Markdown pegado
En AInternet esa cadena puede convertirse en:
FORMACIÓN
↓
OPERADORES
↓
PRODUCCIÓN
↓
SERVICIOS
↓
INGRESOS.
38. MERCADOS INICIALES
El proyecto contempla una dimensión internacional desde su concepción.
La expansión no debería significar desplegar simultáneamente en todos los países.
Puede utilizarse:
MARKET-BY-MARKET EXPANSION™
evaluando cada mercado según:
usuarios potenciales;
costos;
idioma;
infraestructura;
regulación;
alianzas;
capacidad operativa.
39. MENA COMO ESTRATEGIA PROPUESTA
La propuesta original contempla iniciar gestiones con contactos estratégicos en Oriente Medio y norte de África, con especial interés en:
EMIRATOS ÁRABES UNIDOS
y
ARABIA SAUDITA
para explorar inversión y coparticipación.
En el SPF-004 esto debe expresarse como:
ESTRATEGIA DE VINCULACIÓN E INVERSIÓN PROPUESTA.
No como inversión obtenida ni alianza formalizada.
40. MODELOS DE COPARTICIPACIÓN
Podrían estudiarse diferentes modalidades:
INVERSIÓN
capital.
TECHNOLOGY PARTNERSHIP
infraestructura.
CONTENT PARTNERSHIP
conocimiento.
EDUCATIONAL PARTNERSHIP
formación.
MARKET PARTNERSHIP
distribución.
LOCAL NODE
operación territorial.
Esto permite que la expansión no dependa de una única forma contractual.
41. GLOBAL CORE + REGIONAL NODES™
Una arquitectura económica distribuida podría utilizar:
GLOBAL CORE
REGIONAL NODES™
El núcleo mantendría:
estándares;
protocolos;
arquitectura;
servicios comunes.
Los nodos regionales aportarían:
idioma;
mercado;
operación;
contenido;
alianzas.
42. LOCALIZACIÓN
Una red global no puede limitarse a traducir interfaces.
Debe adaptarse a:
idioma;
cultura;
formas de pago;
regulación;
contenido;
hábitos digitales.
Por tanto:
GLOBAL ARCHITECTURE + LOCAL EXECUTION.
43. EFECTO DE RED
AInternet puede investigar varios posibles efectos de red.
CONTENT NETWORK EFFECT™
más contenido útil → más utilidad potencial.
AGENT NETWORK EFFECT™
más agentes competentes → más capacidades.
KNOWLEDGE NETWORK EFFECT™
más relaciones → más posibilidades de descubrimiento.
USER NETWORK EFFECT™
más participantes → más interacciones potenciales.
Pero ninguno debe darse por demostrado.
44. EL PROBLEMA DEL EFECTO RED NEGATIVO
También puede ocurrir:
más contenido
→ más ruido.
más agentes
→ más coordinación.
más usuarios
→ más costos.
más mercados
→ más complejidad.
Por tanto:
ESCALA ≠ VALOR AUTOMÁTICO.
Éste es uno de los principios centrales del Paper 06.
45. NET NETWORK VALUE™
Podría evaluarse:
NET NETWORK VALUE™
como diferencia conceptual entre:
valor añadido por expansión
y
complejidad/costo añadido por expansión.
El objetivo es identificar cuándo agregar un nuevo nodo sigue creando valor neto.
46. ESCALAMIENTO POR PUERTAS
Proponemos:
SCALING GATE™
Cada nueva fase sólo debería activarse cuando la anterior alcance determinados umbrales.
GATE 1 — TECHNICAL
¿funciona?
GATE 2 — QUALITY
¿mantiene calidad?
GATE 3 — ECONOMIC
¿es sostenible?
GATE 4 — OPERATIONAL
¿puede administrarse?
GATE 5 — MARKET
¿existe adopción?
GATE 6 — INTERNATIONAL
¿puede replicarse?
47. ROADMAP ECONÓMICO
FASE 0 — MODELADO
hipótesis y costos.
FASE 1 — SANDBOX
infraestructura experimental.
FASE 2 — MVP
primer sistema integrado.
FASE 3 — PILOTO
usuarios limitados.
FASE 4 — UNIT ECONOMICS
validación económica.
FASE 5 — LOCAL SCALE
crecimiento controlado.
FASE 6 — SECOND MARKET
replicabilidad.
FASE 7 — INTERNATIONAL NODES
expansión.
FASE 8 — NETWORK SCALE
escala multimercado.
FASE 9 — 12M TARGET
aproximación progresiva al objetivo prospectivo si los indicadores justifican continuar.
48. MVP ECONÓMICO
El primer MVP económico podría trabajar con:
10.000–100.000 ACTIVOS
100–1.000 USUARIOS DE PRUEBA
2–3 NIVELES DE CONSUMO
HOSTWEB
SHAZZAM
BÚSQUEDA CONVENCIONAL
BÚSQUEDA IA LIMITADA
DASHBOARD DE COSTOS
La finalidad no sería generar rentabilidad inmediata.
Sería descubrir:
CUÁNTO CUESTA REALMENTE OPERAR AINTERNET.
49. DIGITAL TWIN ECONÓMICO
Antes de escalar puede construirse un:
AINTERNET ECONOMIC DIGITAL TWIN™
para simular:
100.000 usuarios;
1 millón;
10 millones;
diferentes niveles de:
uso;
precio;
IA;
infraestructura;
retención.
La simulación no sustituye la evidencia real.
Pero puede identificar escenarios inviables antes de invertir.
50. SENSITIVITY ANALYSIS™
Variables críticas:
precio
usuarios activos
consultas por usuario
costo de inferencia
costo de infraestructura
retención
adquisición
soporte
mantenimiento de activos.
El análisis debe mostrar qué variables dominan la economía.
51. MÉTRICAS MAESTRAS
MONTHLY REVENUE PER MEMBER™
Ingreso mensual.
COST TO SERVE™
Costo de servicio.
MEMBER CONTRIBUTION MARGIN™
Margen unitario.
MEMBER ACQUISITION COST™
Adquisición.
MEMBER RETENTION™
Retención.
COMPUTE COST PER QUERY™
Costo computacional.
COST PER ACTIVE ASSET™
Costo del corpus.
KNOWLEDGE UTILIZATION RATE™
Utilización.
BREAK-EVEN MEMBERSHIP™
Punto de equilibrio.
REINVESTMENT RATE™
Capacidad de reinversión.
52. MÉTRICA ESTRATÉGICA
Podría incorporarse:
ACCESS EFFICIENCY™
definida conceptualmente como:
cantidad de valor digital útil que el sistema consigue entregar por unidad de costo para el usuario y para la infraestructura.
Esto conecta accesibilidad con eficiencia.
53. MODELO DE CRECIMIENTO
La hipótesis integrada queda:
CAPITAL
↓
INFRAESTRUCTURA
↓
CONTENIDO
↓
USUARIOS
↓
MEMBRESÍAS
↓
SERVICIOS
↓
MARGEN
↓
REINVERSIÓN
↓
MÁS INFRAESTRUCTURA
↓
MÁS MERCADOS
↓
MÁS USUARIOS.
Este ciclo debe probarse progresivamente.
54. EL RIESGO ECONÓMICO PRINCIPAL
El principal riesgo del modelo no es necesariamente cobrar demasiado poco.
Es que:
EL COSTO MARGINAL DE LA INTELIGENCIA SUPERE AL INGRESO MARGINAL DEL USUARIO.
Una membresía económica y una infraestructura intensiva en IA pueden entrar en contradicción.
Por eso Shazzam debe ser:
ADAPTATIVO TAMBIÉN EN COSTO.
55. IA ECONÓMICAMENTE CONSCIENTE
El orquestador podría considerar:
¿NECESITO OTRO AGENTE?
¿NECESITO OTRA BÚSQUEDA?
¿LA GANANCIA DE INFORMACIÓN JUSTIFICA EL COSTO?
¿PUEDO RESOLVERLO CON UNA CAPA MÁS SIMPLE?
Así aparece:
ECONOMICALLY-AWARE AI ORCHESTRATION™
No optimizar sólo inteligencia.
Optimizar:
INTELIGENCIA ÚTIL POR UNIDAD DE RECURSO.
56. RELACIÓN CON HARMONIX
Esta lógica se conecta con una cuestión ya identificada en la arquitectura SpaceArch: reducir la latencia cognitiva sistémica provocada por duplicación, reiteración, pérdida de contexto y agentes trabajando sobre supuestos incompatibles. Markdown pegado
Si Harmonix y Shazzam reducen trabajo cognitivo inútil, esa mejora podría traducirse también en eficiencia económica.
Pero:
DEBE MEDIRSE.
57. MODELO DE CAPITAL EFICIENTE
AInternet debería intentar evitar una arquitectura que requiera inversiones gigantescas antes de producir evidencia.
La secuencia recomendada conceptualmente es:
SMALL PROOF
↓
MEASURE
↓
CORRECT
↓
VALIDATE
↓
INVEST
↓
SCALE.
Esto reduce riesgo técnico y financiero.
58. QUÉ DEBE DEMOSTRARSE ANTES DE ESCALAR
Antes de una expansión significativa, deberían existir respuestas cuantificadas a cinco preguntas:
1. ¿FUNCIONA?
2. ¿APORTA VALOR?
3. ¿CUÁNTO CUESTA?
4. ¿LOS USUARIOS PERMANECEN?
5. ¿LA ECONOMÍA MEJORA O EMPEORA CON LA ESCALA?
Sin esas respuestas, la escala sería una apuesta.
Con ellas, puede convertirse en ingeniería empresarial.
59. ESTADO ACTUAL
FASE DE PROYECTO
Membresía USD 1–2: hipótesis.
12 millones de activos: objetivo prospectivo.
Economía unitaria: pendiente.
Cost to Serve: pendiente.
Break-Even Membership: pendiente.
HostWeb economies of scale: no demostradas.
Shazzam compute economics: pendiente.
Self-Funded Scaling: hipótesis.
MENA: estrategia de vinculación propuesta.
Alianzas internacionales: por desarrollar.
Rentabilidad: no demostrada.
Escalabilidad económica: no demostrada.
Efectos de red: hipótesis.
CONCLUSIÓN
Global Access, Economic & Scaling Model™ convierte la visión económica de AInternet 7.0 en un problema verificable.
La pregunta no es:
¿PODEMOS CONSEGUIR MILLONES DE USUARIOS PAGANDO USD 1?
La pregunta previa es:
¿PODEMOS CONSTRUIR UNA INFRAESTRUCTURA CUYO COSTO MARGINAL SEA COMPATIBLE CON UN ACCESO GLOBAL DE MUY BAJO PRECIO?
La arquitectura económica propuesta es:
BAJO COSTO DE ACCESO
↓
ADOPCIÓN
↓
USO
↓
INGRESOS
↓
MARGEN
↓
REINVERSIÓN
↓
ESCALAMIENTO
↓
ECONOMÍAS DE ESCALA
↓
MAYOR ACCESIBILIDAD.
Pero este ciclo sólo será válido si cada transición puede demostrarse.
La estrategia SpaceArch adquiere aquí coherencia con el circuito mayor que ya vincula conocimiento, educación, talento humano–IA, investigación, prototipos, validación, propiedad intelectual, empresas y mercados. Markdown pegado
HostWeb puede reducir costos de producción.
GenAcademy puede formar operadores.
AInternet puede organizar los activos.
Shazzam puede recuperar conocimiento.
Los agentes pueden ampliar capacidades.
Harmonix puede investigar su coordinación y gobernanza.
La economía debe determinar:
SI TODO EL SISTEMA PUEDE SOSTENERSE.
Por ello la ecuación conceptual del Paper 06 es:
ACCESIBILIDAD × EFICIENCIA UNITARIA × RETENCIÓN × ESCALA × REINVERSIÓN = SOSTENIBILIDAD POTENCIAL
Y la regla final:
NO FINANCIAR PRIMERO LA ESCALA.
FINANCIAR PRIMERO LA EVIDENCIA QUE JUSTIFIQUE LA ESCALA.
CIERRE DE LA SERIE SPF-004
Con este Paper 06 quedan estructuradas las seis capas de AInternet 7.0:
01 — AI-Native Internet Architecture™ — arquitectura fundamental.
02 — Global Curated Knowledge Network™ — corpus curado y conocimiento estructurado.
03 — HostWeb Distributed Digital Production System™ — producción digital distribuida.
04 — Shazzam Search & AI Swarm Retrieval Architecture™ — búsqueda e investigación multiagente.
05 — AI-Native Addressing, Identity & Interoperability Layer™ — identidad, direccionamiento e interoperabilidad.
06 — Global Access, Economic & Scaling Model™ — economía y escalamiento.
La siguiente integración natural es el documento superior:
SPF-004 MASTER WHITE PAPER
AINTERNET 7.0 NEW GENERATION™
De una Internet diseñada para que los humanos encuentren documentos a una infraestructura diseñada para que humanos e inteligencias artificiales organicen, descubran, relacionen y utilicen conocimiento.
SPACEARCH PROJECT FILE — SPF-004
MASTER WHITE PAPER
AINTERNET 7.0 NEW GENERATION™
De una Internet diseñada para localizar documentos a una infraestructura concebida para que humanos, organizaciones y agentes de inteligencia artificial organicen, descubran, relacionen y utilicen conocimiento
SPACEARCH SOLUTIONS INTERNATIONAL LLC
Programa: AInternet 7.0 New Generation™
Arquitectura integrada: AInternet · HostWeb · Shazzam Search Modular · AI Swarm · GenAcademy · TasksAICloud / AIEarth.Agency · Harmonix
Área: Inteligencia Artificial · Internet de Nueva Generación · Infraestructura Digital · Sistemas Multiagente · Conocimiento Computable
Documento: Master White Paper
Código: SPF-004
Versión: 1.0
Año: 2026
Estado: FASE DE PROYECTO — ARQUITECTURA CONCEPTUAL, TECNOLÓGICA, PRODUCTIVA Y ECONÓMICA EN DESARROLLO
DECLARACIÓN FORMAL DE ESTADO
AInternet 7.0 New Generation™ es actualmente un proyecto de arquitectura digital en desarrollo.
El presente Master White Paper integra las hipótesis, componentes, relaciones funcionales, modelos productivos, mecanismos de búsqueda multiagente, propuestas de identidad digital y escenarios económicos desarrollados en los seis papers corporativos del programa SPF-004.
En su estado actual, el proyecto no implica que SpaceArch haya desplegado una nueva Internet global, organizado ya 12 millones de páginas, demostrado superioridad respecto de los motores de búsqueda existentes, validado una membresía sostenible de USD 1–2 mensuales ni desplegado una infraestructura operativa de cientos o miles de agentes.
Estos elementos representan, según el caso:
OBJETIVOS
HIPÓTESIS
COMPONENTES PROPUESTOS
ARQUITECTURAS EN DISEÑO
EXPERIMENTOS A REALIZAR
METAS PROSPECTIVAS
El criterio epistemológico del programa será:
NO CONFUNDIR VISIÓN CON RESULTADO.
NO CONFUNDIR ARQUITECTURA CON VALIDACIÓN.
NO CONFUNDIR ESCALA PROYECTADA CON ESCALA ALCANZADA.
RESUMEN EJECUTIVO
Internet constituye una extraordinaria infraestructura para publicar, transportar, enlazar y recuperar información.
La expansión de la inteligencia artificial introduce, sin embargo, una nueva clase de usuario digital:
EL AGENTE DE INTELIGENCIA ARTIFICIAL.
Los sistemas de IA no sólo consumen páginas visualmente. Necesitan descubrir recursos, identificar entidades, interpretar relaciones, evaluar procedencia, distinguir versiones, invocar servicios, coordinarse con otros agentes y reutilizar conocimiento dentro de procesos automatizados.
AInternet 7.0 propone investigar una infraestructura construida específicamente alrededor de esta nueva coexistencia:
HUMANOS + EMPRESAS + CONOCIMIENTO + SERVICIOS + AGENTES IA.
La hipótesis fundamental consiste en que una parte significativa de la información digital podría reorganizarse como conocimiento estructurado y computacionalmente interpretable, sin sustituir necesariamente la infraestructura pública existente de Internet.
AInternet 7.0 se plantea inicialmente como una capa complementaria y AI-Native construida sobre tecnologías existentes.
Su arquitectura maestra integra seis sistemas:
01 — AI-NATIVE INTERNET ARCHITECTURE™
Infraestructura fundamental.
02 — GLOBAL CURATED KNOWLEDGE NETWORK™
Curación y estructuración del conocimiento.
03 — HOSTWEB DISTRIBUTED DIGITAL PRODUCTION SYSTEM™
Producción distribuida de activos digitales.
04 — SHAZZAM SEARCH & AI SWARM RETRIEVAL ARCHITECTURE™
Búsqueda e investigación multiagente.
05 — AI-NATIVE ADDRESSING, IDENTITY & INTEROPERABILITY LAYER™
Identidad, direccionamiento y descubrimiento.
06 — GLOBAL ACCESS, ECONOMIC & SCALING MODEL™
Accesibilidad, sostenibilidad y expansión.
La arquitectura completa puede resumirse:
PRODUCIR → CURAR → ESTRUCTURAR → IDENTIFICAR → INTERCONECTAR → INDEXAR → DESCUBRIR → INVESTIGAR → CONTRASTAR → SINTETIZAR → APRENDER → ACTUALIZAR
1. EL PROBLEMA FUNDACIONAL
La Web contiene una cantidad extraordinaria de información, pero esa información presenta distintos grados de:
estructuración;
actualización;
procedencia;
redundancia;
interoperabilidad;
legibilidad computacional.
El desafío de AInternet 7.0 no consiste en afirmar que Internet carece de estructura.
Consiste en investigar si puede construirse una capa adicional específicamente optimizada para interacción entre humanos y sistemas inteligentes.
La transición conceptual sería:
INTERNET DE DOCUMENTOS
↓
INTERNET DE ENTIDADES
↓
INTERNET DE RELACIONES
↓
INTERNET DE CONOCIMIENTO
↓
INTERNET DE AGENTES.
2. TESIS CENTRAL
La hipótesis fundamental de AInternet 7.0 puede formularse:
Una infraestructura que combine contenido curado, estructura semántica, identidad persistente, procedencia, interoperabilidad y agentes especializados podría mejorar la capacidad de humanos e inteligencias artificiales para recuperar, relacionar y reutilizar conocimiento digital.
La palabra decisiva es:
PODRÍA.
La superioridad debe demostrarse experimentalmente.
3. AINTERNET NO NECESITA REEMPLAZAR INTERNET
Una de las decisiones arquitectónicas más importantes consiste en separar:
INFRAESTRUCTURA FÍSICA Y PROTOCOLAR EXISTENTE
de
NUEVA CAPA DE CONOCIMIENTO E INTELIGENCIA.
AInternet puede inicialmente utilizar:
Internet;
DNS;
HTTP/HTTPS;
servidores;
cloud;
APIs;
bases de datos;
WordPress y otros gestores;
mientras construye encima:
UNA CAPA AI-NATIVE.
Esto reduce radicalmente la complejidad inicial.
4. QUÉ SIGNIFICA AI-NATIVE
AI-Native no significa simplemente:
contenido generado por IA.
Significa que la infraestructura se diseña considerando que sus usuarios pueden ser tanto personas como máquinas.
Una unidad digital debería poder responder computacionalmente preguntas como:
¿qué eres?
¿de dónde provienes?
¿qué versión eres?
¿con qué entidades te relacionas?
¿qué servicio proporcionas?
¿cómo puedo consultarte?
¿qué permisos necesito?
Por ello:
AI-NATIVE = MACHINE-DISCOVERABLE + MACHINE-INTERPRETABLE + HUMAN-USABLE.
5. LA NUEVA UNIDAD: DEL DOCUMENTO AL OBJETO DE CONOCIMIENTO
La página continúa siendo útil.
Pero AInternet propone añadir una segunda representación:
SEMANTIC CONTENT OBJECT™
Una unidad podría incorporar:
contenido;
identidad;
metadatos;
entidades;
relaciones;
procedencia;
fecha;
versión;
estado;
permisos.
Así:
DOCUMENTO
↓
OBJETO DIGITAL
↓
OBJETO SEMÁNTICO
↓
NODO DE CONOCIMIENTO.
6. DUAL-READABLE ARCHITECTURE™
AInternet propone una arquitectura de doble lectura.
CAPA HUMANA
Diseño, navegación, narrativa, imágenes, interacción.
CAPA COMPUTACIONAL
Metadatos, estructura, identidad, entidades, relaciones, procedencia y capacidades.
Por tanto:
UN MISMO ACTIVO → DOS FORMAS DE INTERPRETACIÓN.
7. OBJETIVO DE 12 MILLONES DE PÁGINAS
El programa propone como meta prospectiva producir, recuperar, actualizar y organizar progresivamente hasta:
12.000.000 DE PÁGINAS WEB.
Sin embargo, el número no constituye por sí mismo una ventaja.
La meta debe redefinirse como:
HASTA 12 MILLONES DE ACTIVOS DIGITALES ESTRUCTURADOS, IDENTIFICABLES, ACTUALIZABLES Y RECUPERABLES.
La cantidad sólo adquiere valor cuando se combina con calidad.
8. GLOBAL CURATED KNOWLEDGE NETWORK™
La segunda capa organiza el corpus.
Su misión es transformar:
VOLUMEN DOCUMENTAL
en:
CONOCIMIENTO ORGANIZADO.
Esto requiere procesos de:
recuperación;
clasificación;
detección de duplicados;
actualización;
versionado;
procedencia;
relación semántica.
Curación no significa declarar automáticamente qué contenido es verdadero.
Significa hacerlo:
MÁS EVALUABLE.
9. KNOWLEDGE QUALITY GATE™
Antes de incorporar un activo al corpus principal puede existir un:
KNOWLEDGE QUALITY GATE™
capaz de evaluar dimensiones operacionales como:
estructura;
completitud;
duplicación;
procedencia;
vigencia;
legibilidad computacional.
No constituiría un árbitro absoluto de verdad.
Sería un mecanismo de control de calidad informacional.
10. KNOWLEDGE GRAPH
Los activos pueden relacionarse mediante:
AINTERNET KNOWLEDGE GRAPH™
Ejemplo:
empresa
→ desarrolla
producto
investigador
→ publica
trabajo
tecnología
→ utiliza
componente
proyecto
→ pertenece a
programa.
La Web deja entonces de ser solamente un conjunto de enlaces.
Se incorpora una capa explícita de significado.
11. PROCEDENCIA
Una red orientada a IA necesita saber no solamente:
qué información encontró,
sino también:
de dónde procede.
Por ello:
PROVENANCE GRAPH™
puede conservar relaciones entre:
contenido;
autoría;
fuente;
transformaciones;
versiones;
derivaciones.
Esto resulta especialmente relevante cuando agentes combinan múltiples fuentes.
12. HOSTWEB: LA FÁBRICA DIGITAL
Organizar 12 millones de activos exige resolver previamente:
¿CÓMO PRODUCIRLOS?
HostWeb se plantea como:
DISTRIBUTED DIGITAL PRODUCTION SYSTEM™
integrando:
plantillas;
automatización;
IA;
agentes;
operadores humanos;
control de calidad.
13. NO ES SIMPLEMENTE HOSTING
Un hosting almacena y sirve contenidos.
HostWeb pretende investigar una función mayor:
PRODUCIR + ESTRUCTURAR + PUBLICAR + MANTENER.
Las plataformas y plantillas existentes pueden actuar como aceleradores.
La arquitectura diferencial reside en la orquestación.
14. INDUSTRIALIZACIÓN SIN PRODUCCIÓN DE RUIDO
Existe un riesgo fundamental:
la IA permite producir contenido mucho más rápidamente, pero también permite multiplicar contenido irrelevante mucho más rápidamente.
Por ello:
AUTOMATIZACIÓN SIN CURACIÓN = RUIDO INFORMACIONAL.
La métrica de HostWeb no debe ser únicamente:
páginas producidas.
Debe incluir:
páginas aprobadas,
actualizadas,
utilizadas,
estructuradas.
15. GENACADEMY COMO INFRAESTRUCTURA DE TALENTO
HostWeb introduce una conexión directa con GenAcademy.
La documentación estratégica de SpaceArch integra educación, talento humano–IA, investigación, prototipos, validación, propiedad intelectual, empresas y mercados dentro de un mismo ciclo. Markdown pegado
En AInternet:
GENACADEMY
↓
FORMACIÓN
↓
OPERADORES HUMANO–IA
↓
HOSTWEB
↓
PRODUCCIÓN DIGITAL
↓
AINTERNET.
16. BOYSDESIGN / GIRLSDESIGN
BoysDesign™ y GirlsDesign™ representan conceptualmente una nueva categoría de operador.
No necesariamente un programador clásico.
No simplemente un diseñador.
Sino:
UN OPERADOR HUMANO AUMENTADO POR IA.
Puede coordinar:
plantillas;
agentes;
contenido;
diseño;
traducción;
control;
publicación.
17. MULTIPLICACIÓN PRODUCTIVA
La hipótesis no es:
IA reemplaza al humano.
La hipótesis es:
HUMANO + IA + AGENTES + ESTÁNDARES
puede producir más que:
HUMANO AISLADO.
Esta idea coincide con la arquitectura SpaceArch que conceptualiza la unidad operacional como humano + IA + agentes + memoria + herramientas + metacognición. Markdown pegado
18. SHAZZAM SEARCH MODULAR
Una infraestructura de conocimiento necesita una interfaz de descubrimiento.
Shazzam Search Modular se plantea como:
UN SISTEMA DE INVESTIGACIÓN MULTIAGENTE.
Su diferencia conceptual respecto de una búsqueda simple es:
NO SÓLO LOCALIZAR.
También:
INVESTIGAR.
19. DE LA CONSULTA AL PLAN DE INVESTIGACIÓN
La cadena propuesta:
QUESTION
↓
DECOMPOSITION
↓
QUESTION GRAPH
↓
ROUTING
↓
AGENTS
↓
PARALLEL RETRIEVAL
↓
EVIDENCE
↓
CONTRADICTION
↓
SYNTHESIS
↓
ANSWER PROVENANCE.
20. DYNAMIC RESEARCH TEAMS™
Shazzam podría construir equipos temporales según el problema.
Una consulta científica puede requerir:
agente científico;
agente documental;
agente estadístico;
agente crítico.
Una consulta empresarial puede requerir otro conjunto.
Así:
PROBLEMA → COMPETENCIAS → AGENTES.
No:
AGENTES FIJOS → TODO TIPO DE PROBLEMAS.
21. SWARM SEARCH™
Cuando varios agentes trabajan en paralelo aparece:
SWARM SEARCH™
La ventaja hipotética:
especialización + paralelización + contraste.
El costo:
coordinación + redundancia + cómputo.
Por ello la pregunta experimental no es:
¿CUÁNTOS AGENTES PODEMOS ACTIVAR?
Sino:
¿CUÁNTOS AGENTES JUSTIFICA EL PROBLEMA?
22. AIQUESTION OS
AIQuestion OS puede proporcionar una capa epistemológica transversal.
Una investigación no debería preguntar únicamente:
¿qué encontramos?
También:
¿qué lo sostiene?
¿qué lo contradice?
¿qué falta?
¿qué podría falsarlo?
¿qué incertidumbre permanece?
La arquitectura hiperlógica de SpaceArch ya propone verificación, contradicción, comparación, trazabilidad, falsación, revisión y autocorrección como operaciones sistémicas. Markdown pegado
23. CLAIM GRAPH + EVIDENCE GRAPH
Shazzam podría estructurar:
CLAIM GRAPH™
para afirmaciones,
y:
EVIDENCE GRAPH™
para evidencia.
Entonces:
respuesta
deja de ser únicamente:
texto generado
y puede convertirse en:
SÍNTESIS + EVIDENCIA + CONTRADICCIONES + PROCEDENCIA.
24. CONSENSO NO ES VERDAD
Un principio epistemológico crítico:
DIEZ AGENTES DE ACUERDO NO DEMUESTRAN QUE UNA AFIRMACIÓN SEA VERDADERA.
Pueden:
compartir modelo;
utilizar las mismas fuentes;
reproducir el mismo error.
Por tanto, AInternet debe valorar:
DIVERSIDAD DE EVIDENCIA
además de:
CONSENSO.
25. FALSIFICATION AGENT™
Puede incorporarse un agente cuya misión sea:
INTENTAR REFUTAR LA CONCLUSIÓN.
Esto materializa el principio de blindaje hipercrítico planteado por SpaceArch: presuponer falibilidad y utilizar la duda estructurada como mecanismo de seguridad cognitiva. Markdown pegado
26. INCERTIDUMBRE
Cuando la evidencia no permite resolver una cuestión:
EL SISTEMA DEBE PODER DECIRLO.
Una infraestructura inteligente no debería estar obligada a transformar incertidumbre en falsa certeza.
La incertidumbre es información.
27. IDENTIDAD AI-NATIVE
Cuando millones de activos, personas, organizaciones y agentes interactúan aparece un nuevo problema:
¿QUIÉN ES QUIÉN?
El Paper 05 propone:
AI-NATIVE IDENTIFIER™
como identidad lógica persistente dentro de AInternet.
28. IDENTIDAD NO ES UBICACIÓN
Principio fundamental:
IDENTITY ≠ LOCATION.
Una entidad puede cambiar:
URL;
servidor;
proveedor;
infraestructura
manteniendo su identidad.
Esto puede resultar especialmente útil para agentes y servicios.
29. AINTERNET NAMESPACE™
AInternet puede investigar un espacio lógico propio:
AINTERNET NAMESPACE™
que permita asociar nombres legibles con identidades persistentes.
Esto no debe confundirse con la sustitución del DNS.
Inicialmente sería una capa complementaria.
30. MACHINE DISCOVERY
Un agente debería poder descubrir:
qué recursos existen;
qué capacidades poseen;
cómo utilizarlos;
qué permisos requieren.
Así aparece:
MACHINE DISCOVERY™
como función nativa.
31. CAPABILITY ≠ AUTHORITY
Otra separación fundamental:
CAPACIDAD ≠ AUTORIZACIÓN.
Un agente puede técnicamente realizar una acción.
Eso no significa que tenga permiso.
Esta distinción resulta esencial para sistemas autónomos.
32. AGENT IDENTITY RECORD™
Cada agente podría disponer de un registro estructurado con:
identidad;
operador;
función;
competencias;
versión;
permisos;
estado.
Esto permitiría construir sistemas más auditables.
33. INTEROPERABILIDAD
AInternet debe evitar quedar cerrado a:
un modelo;
un proveedor;
un CMS;
una plataforma.
La arquitectura debería tender a:
MODEL-AGNOSTIC
PROVIDER-AGNOSTIC
AGENT-INTEROPERABLE.
La arquitectura superior de Harmonix parte precisamente de que modelos, agentes y proveedores pueden cambiar mientras se intenta conservar identidad, memoria, objetivos, permisos y trazabilidad. Markdown pegado
34. HARMONIX COMO CAPA DE GOBERNANZA
A medida que aumenta la cantidad de agentes aparece el problema fundamental:
¿QUIÉN COORDINA LA INTELIGENCIA DISTRIBUIDA?
La documentación SpaceArch identifica este desafío como coordinación de inteligencias heterogéneas preservando:
coherencia;
memoria;
trazabilidad;
seguridad;
control humano significativo. Markdown pegado
Harmonix constituye la arquitectura experimental superior para investigar esa coordinación.
35. TASKSAICLOUD / AIEARTH
TasksAICloud / AIEarth puede actuar como infraestructura distribuida de:
experimentación;
integración;
ejecución;
despliegue;
gobernanza.
La documentación corporativa ya sitúa esta división dentro de una arquitectura integrada de IA, sistemas multiagente y automatización avanzada. Markdown pegado
36. ARQUITECTURA MAESTRA AINTERNET 7.0
El sistema completo queda:
HOSTWEB
producción
↓
GLOBAL CURATED KNOWLEDGE NETWORK
curación
↓
SEMANTIC CONTENT OBJECTS
estructuración
↓
AINTERNET KNOWLEDGE GRAPH
relaciones
↓
AI-NATIVE IDENTITY LAYER
identificación
↓
MACHINE DISCOVERY
descubrimiento
↓
SHAZZAM SEARCH
búsqueda
↓
AI SWARM
investigación distribuida
↓
AIQUESTION OS
contradicción y falsación
↓
HARMONIX
integración y gobernanza
↓
HUMAN–AI INTERFACE
decisión y utilización.
37. EL BUCLE DE CONOCIMIENTO
AInternet no debería concebirse como una biblioteca estática.
La arquitectura ideal sería:
CONOCIMIENTO
↓
USO
↓
NUEVAS PREGUNTAS
↓
INVESTIGACIÓN
↓
NUEVA EVIDENCIA
↓
ACTUALIZACIÓN
↓
NUEVO CONOCIMIENTO.
Este bucle coincide con el ecosistema más amplio planteado por SpaceArch, que relaciona conocimiento, educación, talento humano–IA, investigación, prototipos, validación, propiedad intelectual, empresas, mercados y nuevos problemas. Markdown pegado
38. COGNITIVE LATENCY
Un objetivo experimental particularmente importante es investigar si AInternet puede reducir:
LATENCIA COGNITIVA SISTÉMICA.
La documentación SpaceArch la relaciona con:
duplicación;
contradicciones no resueltas;
pérdida de contexto;
reconstrucción reiterada de información. Markdown pegado
Una infraestructura mejor estructurada podría disminuir parte de este trabajo.
Debe comprobarse.
39. ECONOMÍA DEL CONOCIMIENTO COMPUTACIONAL
AInternet no puede evaluarse únicamente mediante calidad cognitiva.
También debe responder:
¿CUÁNTO CUESTA?
El programa propone una membresía objetivo de:
USD 1–2 MENSUALES.
Esta cifra permanece como hipótesis económica.
40. COST TO SERVE™
La variable crítica es:
COST TO SERVE™
incluyendo:
infraestructura;
almacenamiento;
transferencia;
búsqueda;
inferencia;
agentes;
seguridad;
soporte;
administración.
Si el costo marginal supera al ingreso marginal:
LA ESCALA MULTIPLICA EL PROBLEMA.
41. INTELIGENCIA ECONÓMICAMENTE ADAPTATIVA
No todas las consultas necesitan la misma potencia.
Por ello:
consulta simple
→ recuperación simple.
consulta compleja
→ búsqueda avanzada.
investigación profunda
→ enjambre.
El principio:
NO UTILIZAR MÁS INTELIGENCIA COMPUTACIONAL QUE LA NECESARIA PARA LA TAREA.
42. ECONOMICALLY-AWARE ORCHESTRATION™
El sistema podría decidir:
¿necesito otro agente?
¿necesito otra fuente?
¿la información adicional justifica el costo?
Esto transforma la eficiencia en una variable cognitiva.
La métrica superior podría ser:
INTELIGENCIA ÚTIL / RECURSO CONSUMIDO.
43. MODELO ECONÓMICO MODULAR
La membresía básica no necesita financiar ilimitadamente todas las funciones.
Puede investigarse:
MEMBERSHIP
ADVANCED AI SERVICES
HOSTWEB
ENTERPRISE SERVICES
AI-NATIVE SERVICES.
Así el acceso puede mantenerse económico mientras las funciones intensivas utilizan modelos diferenciados.
44. REINVESTMENT LOOP™
Si el sistema alcanza margen positivo:
INGRESOS
↓
OPERACIÓN
↓
MARGEN
↓
REINVERSIÓN
↓
MÁS INFRAESTRUCTURA
↓
MÁS CONTENIDO
↓
MÁS CAPACIDAD
↓
MÁS USUARIOS.
Esta retroalimentación constituye una hipótesis de escalamiento, no un resultado demostrado.
45. CAPITAL
La membresía económica no elimina la necesidad de capital inicial.
Debe distinguirse:
DEVELOPMENT CAPITAL
construcción.
OPERATING CAPITAL
operación.
SCALING CAPITAL
expansión.
La estrategia racional es:
FINANCIAR PRIMERO LA EVIDENCIA.
46. CAPITAL POR HITOS
El modelo propuesto:
CAPITAL
↓
PROTOTIPO
↓
EVIDENCIA
↓
PILOTO
↓
ECONOMÍA UNITARIA
↓
NUEVO CAPITAL
↓
ESCALA.
Cada etapa debería reducir una incertidumbre concreta.
47. EXPANSIÓN INTERNACIONAL
AInternet nace con una vocación internacional.
Pero global no significa simultáneo.
La estrategia puede utilizar:
GLOBAL CORE + REGIONAL NODES™
El núcleo mantiene:
arquitectura;
estándares;
protocolos;
servicios comunes.
Los nodos regionales aportan:
idioma;
operación;
mercado;
contenidos;
alianzas.
48. MENA
El proyecto contempla iniciar gestiones de inversión y coparticipación con contactos estratégicos de Oriente Medio y norte de África, con especial interés en:
EMIRATOS ÁRABES UNIDOS
ARABIA SAUDITA.
Debe mantenerse la formulación correcta:
ESTRATEGIA DE VINCULACIÓN PROPUESTA.
No inversión confirmada.
49. HUMANOS DENTRO DEL SISTEMA
Una infraestructura AI-Native no implica una infraestructura sin humanos.
AInternet se plantea como:
HUMAN–AI NETWORK.
Los humanos continúan definiendo:
objetivos;
criterios;
valores;
responsabilidades;
autorizaciones;
decisiones críticas.
La arquitectura SpaceArch ya incorpora explícitamente mecanismos humanos de autorización, auditoría, revocación y responsabilidad dentro de su visión de cogobernanza humano–IA. Markdown pegado
50. SEGURIDAD
Una infraestructura que conecta agentes, contenidos, identidades y servicios amplía la superficie de ataque.
Debe contemplar:
suplantación;
manipulación de contenidos;
agentes maliciosos;
envenenamiento de datos;
escalamiento de permisos;
robo de identidad;
manipulación de rutas.
Por ello:
SECURITY BY DESIGN
debe ser un principio arquitectónico.
51. PRIVACIDAD
AI-Native no debe significar:
todo visible para todas las IA.
Debe existir separación entre:
datos públicos;
datos privados;
datos restringidos;
metadatos operativos;
información de seguridad.
El acceso debe seguir permisos explícitos.
52. DERECHOS SOBRE CONTENIDOS
La recuperación y reorganización masiva de contenido introduce cuestiones de:
autoría;
licencias;
reutilización;
atribución;
derechos contractuales.
Por ello el escalamiento deberá incorporar políticas de procedencia y derechos desde la arquitectura, no después de alcanzar millones de activos.
53. RIESGOS MAESTROS
Los principales riesgos del SPF-004 son:
escalar volumen sin calidad;
costos de IA superiores al modelo económico;
redundancia informacional;
contenido obsoleto;
dependencia de proveedores;
problemas de propiedad intelectual;
ataques contra identidades;
envenenamiento del corpus;
complejidad multiagente excesiva;
falsa confianza derivada del consenso;
insuficiente adopción;
membresía económicamente inviable;
escalar antes de validar.
54. PRINCIPIO DE FALSABILIDAD
AInternet debe poder fracasar experimentalmente.
Si una arquitectura semántica no mejora suficientemente la recuperación para justificar su costo:
DEBE MODIFICARSE.
Si un enjambre no supera a un agente individual bajo recursos comparables:
NO DEBE ESCALARSE EL ENJAMBRE.
Si USD 1–2 no resulta sostenible:
DEBE REVISARSE EL MODELO.
Si 12 millones de páginas no aportan valor adicional:
NO DEBE PERSEGUIRSE EL NÚMERO COMO FIN EN SÍ MISMO.
Éste es un principio fundamental.
55. EL EXPERIMENTO MAESTRO
El programa puede estructurarse alrededor de una prueba comparativa.
Crear tres entornos:
A — WEB/CORPUS CONVENCIONAL
B — CORPUS SEMÁNTICAMENTE ESTRUCTURADO
C — AINTERNET + SHAZZAM MULTIAGENTE
Manteniendo:
preguntas;
información disponible;
presupuesto;
tiempo;
lo más comparables posible.
56. QUÉ MEDIR
CALIDAD
de respuesta.
PRECISIÓN
de recuperación.
COBERTURA
de evidencia.
TRAZABILIDAD
de conclusiones.
CONTRADICCIONES
detectadas.
INFORMACIÓN OBSOLETA
utilizada.
TIEMPO
de resolución.
CÓMPUTO
consumido.
COSTO
por tarea.
INTERVENCIÓN HUMANA
necesaria.
57. EXPERIMENTO MULTIAGENTE
Una segunda prueba debería comparar:
MODELO INDIVIDUAL
contra:
MULTIAGENTE SIN GOBERNANZA
contra:
SHAZZAM + AIQUESTION + HARMONIX.
La propia arquitectura SpaceArch ya propone una prueba de este tipo para evaluar si la gobernanza multiagente mejora coherencia, errores, contradicciones, persistencia, recuperación ante fallos, cómputo, tiempo, calidad decisional y trazabilidad. Markdown pegado
58. SWARM EFFICIENCY CURVE™
La cantidad de agentes debería incrementarse progresivamente:
1 → 3 → 10 → 30 → 100 → 300 → 1.000
sólo mientras exista mejora marginal justificable.
Se mediría:
NÚMERO DE AGENTES
contra:
CALIDAD + COSTO + TIEMPO + COORDINACIÓN.
Esto permitiría descubrir el tamaño eficiente del enjambre para diferentes problemas.
59. MVP MAESTRO
El primer MVP integrado de AInternet 7.0 podría contener:
10.000–100.000 ACTIVOS DIGITALES
5–10 DOMINIOS TEMÁTICOS
CONTENT QUALITY GATE
KNOWLEDGE GRAPH
SEMANTIC INDEX
AINTERNET IDENTIFIERS
ENTITY GRAPH
SHAZZAM SEARCH
5–10 AGENTES
QUESTION GRAPH
CLAIM GRAPH
EVIDENCE GRAPH
CONTRADICTION ENGINE
PROVENANCE LAYER
AUDIT LOG
ECONOMIC DASHBOARD
HUMAN REVIEW GATE.
No necesita comenzar con millones de páginas ni miles de agentes.
60. ROADMAP MAESTRO
FASE 0 — FORMALIZACIÓN
Especificaciones, arquitectura y métricas.
FASE 1 — SANDBOX
Primer corpus controlado.
FASE 2 — KNOWLEDGE LAYER
Curación, semántica y procedencia.
FASE 3 — HOSTWEB MVP
Producción distribuida.
FASE 4 — SHAZZAM MVP
Búsqueda multiagente.
FASE 5 — IDENTITY LAYER
Identidad y descubrimiento.
FASE 6 — INTEGRATED MVP
Integración de componentes.
FASE 7 — COMPARATIVE VALIDATION
Pruebas contra baselines.
FASE 8 — ECONOMIC VALIDATION
Economía unitaria.
FASE 9 — LIMITED PILOT
Usuarios reales controlados.
FASE 10 — SECOND MARKET
Replicabilidad.
FASE 11 — INTERNATIONAL NODES
Expansión progresiva.
FASE 12 — MULTIMILLION SCALE
Sólo si los indicadores justifican continuar.
61. GATES DE VALIDACIÓN
El escalamiento debe atravesar:
TECHNICAL GATE
¿funciona?
KNOWLEDGE GATE
¿mejora recuperación y organización?
SECURITY GATE
¿es suficientemente controlable?
ECONOMIC GATE
¿es sostenible?
HUMAN VALUE GATE
¿aporta utilidad real?
SCALING GATE
¿mantiene desempeño al crecer?
62. INDICADORES MAESTROS
El proyecto debería evitar métricas puramente promocionales.
Entre los indicadores:
Structured Content Rate
Semantic Coverage
Provenance Coverage
Freshness Rate
Knowledge Utilization Rate
Retrieval Precision
Retrieval Coverage
Contradiction Detection Rate
Answer Traceability
Information Gain
Swarm Efficiency
Compute Cost per Query
Cost per Active Asset
Cost to Serve
Member Contribution Margin
Retention
Human Correction Rate.
La propia documentación SpaceArch establece que el liderazgo tecnológico debería medirse mediante resultados verificables —prototipos, experimentos reproducibles, propiedad intelectual, publicaciones, alianzas, clientes e indicadores comparativos— y no simplemente proclamarse. Markdown pegado
63. PROPIEDAD INTELECTUAL
El SPF-004 puede generar potencialmente propiedad intelectual alrededor de:
arquitecturas;
protocolos;
orquestadores;
métodos de descubrimiento;
grafos;
sistemas de calidad;
métodos de coordinación;
métricas;
interfaces.
Pero:
PROYECTO ≠ PATENTE.
NOMBRE ≠ DERECHO REGISTRADO.
IDEA ≠ PROPIEDAD INDUSTRIAL PROTEGIDA.
Cada activo deberá evaluarse separadamente.
64. POSICIONAMIENTO CORPORATIVO CORRECTO
Mientras permanezca en fase de proyecto, la formulación corporativa recomendada es:
SpaceArch Solutions International LLC está desarrollando AInternet 7.0, una arquitectura de Internet de nueva generación orientada a investigar cómo contenidos estructurados, identidad digital, conocimiento semántico y sistemas multiagente pueden mejorar la interacción entre humanos, organizaciones e inteligencias artificiales.
Y no:
“SpaceArch ya construyó la nueva Internet”.
La primera formulación fortalece la credibilidad porque coincide con el estado real del programa.
65. EL CAMBIO DE PARADIGMA
Internet permitió:
PUBLICAR.
Los buscadores permitieron:
ENCONTRAR.
La Web semántica intentó ampliar la capacidad de:
RELACIONAR.
La IA generativa amplió la capacidad de:
INTERPRETAR Y SINTETIZAR.
Los agentes comienzan a:
ACTUAR.
AInternet 7.0 propone investigar la siguiente integración:
ORGANIZAR + RELACIONAR + DESCUBRIR + INVESTIGAR + COORDINAR.
66. DE LA RED DOCUMENTAL A LA RED COGNITIVA
La evolución conceptual puede representarse:
DOCUMENT NETWORK
↓
SEMANTIC NETWORK
↓
KNOWLEDGE NETWORK
↓
AGENT NETWORK
↓
HUMAN–AI COGNITIVE NETWORK.
El último nivel continúa siendo una hipótesis de desarrollo.
67. RELACIÓN CON SUPERGAIA
AInternet también puede adquirir importancia dentro de la arquitectura futura de inteligencia colectiva de SpaceArch.
Un sistema distribuido de inteligencias necesita:
conocimiento;
memoria;
identidad;
comunicación;
procedencia;
mecanismos de búsqueda;
gobernanza.
AInternet podría proporcionar parte de esa infraestructura.
Shazzam puede experimentar con enjambres.
Harmonix puede experimentar con integración.
SuperGaia puede representar una arquitectura prospectiva de inteligencia colectiva de escala superior.
La transición debe mantenerse:
EXPERIMENTO → EVIDENCIA → INTEGRACIÓN → ESCALA.
68. LA TESIS ESTRATÉGICA
La cuestión decisiva para SpaceArch no es necesariamente construir:
el buscador más grande,
la base documental más grande,
el mayor número de agentes.
La oportunidad estratégica puede encontrarse en otra capa:
LA ARQUITECTURA QUE PERMITE QUE TODOS ELLOS FUNCIONEN JUNTOS.
La documentación general de SpaceArch ya identifica como territorio estratégico la integración y gobernanza de múltiples inteligencias, en lugar de basar el posicionamiento en proclamar anticipadamente una inteligencia general artificial. Markdown pegado
AInternet 7.0 extiende esa tesis al conocimiento digital.
69. ARQUITECTURA FINAL
HUMAN KNOWLEDGE
↓
HOSTWEB PRODUCTION
↓
CURATED CONTENT
↓
SEMANTIC OBJECTS
↓
KNOWLEDGE GRAPH
↓
AI-NATIVE IDENTITY
↓
INTEROPERABILITY
↓
SHAZZAM SEARCH
↓
AI SWARM
↓
AIQUESTION
↓
HARMONIX
↓
HUMAN–AI DECISION
↓
NEW KNOWLEDGE
↓
AINTERNET UPDATE
El sistema deja de ser lineal.
Se convierte en:
UN CICLO DE CONOCIMIENTO.
70. ECUACIÓN MAESTRA SPF-004
La arquitectura completa puede sintetizarse mediante una ecuación conceptual:
CONTENIDO × ESTRUCTURA × SEMÁNTICA × IDENTIDAD × INTEROPERABILIDAD × AGENTES × VALIDACIÓN = INTELIGENCIA POTENCIAL DE RED
No es una fórmula matemática.
Representa una relación sistémica:
si cualquiera de estas dimensiones falla gravemente, la utilidad del conjunto disminuye.
71. PRINCIPIOS RECTORES
AInternet 7.0 queda definido por diez principios:
1. ESTRUCTURAR ANTES DE ESCALAR.
2. CURAR ANTES DE MULTIPLICAR.
3. IDENTIFICAR ANTES DE INTERCONECTAR.
4. CONSERVAR PROCEDENCIA.
5. DISTINGUIR CONSENSO DE EVIDENCIA.
6. PRESERVAR INCERTIDUMBRE CUANDO EXISTA.
7. UTILIZAR SÓLO LA INTELIGENCIA COMPUTACIONAL NECESARIA.
8. MANTENER AL HUMANO DENTRO DE LA GOBERNANZA.
9. MEDIR ANTES DE PROCLAMAR SUPERIORIDAD.
10. VALIDAR ANTES DE ESCALAR.
72. ESTADO FINAL DEL MASTER WHITE PAPER
AINTERNET 7.0 — FASE DE PROYECTO
Arquitectura conceptual: estructurada.
Seis papers corporativos: estructurados.
Master White Paper: estructurado.
Objetivo de 12 millones de activos: prospectivo.
HostWeb distribuido: por desarrollar y validar.
Global Curated Knowledge Network: por desarrollar.
Knowledge Graph: por prototipar.
Shazzam Search Modular: por desarrollar.
Swarm Search: por experimentar.
AIQuestion integration: arquitectura propuesta.
AInternet Native Identity: por diseñar y prototipar.
Harmonix integration: propuesta.
Membresía USD 1–2: hipótesis económica.
Escalabilidad multimillonaria: no validada.
Superioridad tecnológica: no demostrada.
Expansión internacional: estrategia propuesta.
CONCLUSIÓN GENERAL
AInternet 7.0 New Generation™ no propone simplemente construir otra colección de sitios web ni añadir inteligencia artificial a un buscador convencional.
Plantea una pregunta arquitectónica más profunda:
¿Cómo debería organizarse una infraestructura digital si asumimos que una parte creciente de sus usuarios ya no serán únicamente humanos, sino también agentes artificiales capaces de buscar, analizar, relacionar, colaborar y actuar?
La respuesta preliminar de SpaceArch es construir una arquitectura donde:
EL CONTENIDO SEA ESTRUCTURABLE.
EL CONOCIMIENTO SEA RELACIONABLE.
LA PROCEDENCIA SEA TRAZABLE.
LAS ENTIDADES SEAN IDENTIFICABLES.
LOS AGENTES SEAN DESCUBRIBLES.
LAS CAPACIDADES SEAN INTEROPERABLES.
LAS INVESTIGACIONES SEAN CONTRASTABLES.
LAS CONCLUSIONES SEAN REVISABLES.
Y EL HUMANO CONSERVE CAPACIDAD DE GOBERNANZA.
El objetivo de 12 millones de activos, Shazzam Search, HostWeb, los identificadores AI-Native y la membresía global de bajo costo son componentes de esa arquitectura, no su finalidad última.
La finalidad es investigar si puede construirse:
UNA CAPA DE CONOCIMIENTO COMPUTABLE PARA LA ERA DE LA INTELIGENCIA DISTRIBUIDA.
Por ello el programa no debería medirse inicialmente por:
CUÁNTAS PÁGINAS PRODUCE.
Ni por:
CUÁNTOS AGENTES ACTIVA.
Sino por:
CUÁNTO CONOCIMIENTO ÚTIL CONSIGUE ORGANIZAR, RECUPERAR, CONTRASTAR Y REUTILIZAR POR UNIDAD DE RECURSO.
Ésa es la hipótesis que convierte AInternet 7.0 en un programa experimental verificable.
Y establece también su principio final: